Medición del uso de ancho de banda: métodos, KPI y configuración
Published
Gestione un hotel, un campus o una cadena de recintos, el informe mensual puede indicar que el enlace ascendente solo se utiliza en parte. Sin embargo, llega la noche, la red de invitados se ralentiza y las incidencias empiezan a aparecer de todos modos. Esa discrepancia es el resultado de una medición del uso del ancho de banda deficiente que se limita a ofrecer un total mensual.
El volumen medio es una referencia útil. No describe la hora punta, la dirección del tráfico ni qué grupo estaba en la red a las 21:00. El cifrado empeora el atajo habitual, ya que los números de puerto y la inspección de la carga útil ya no identifican la aplicación de forma fiable.
Lo que sigue funcionando es más preciso. Consiste en contar bytes en ambas direcciones en un punto determinado, tomar muestras con la frecuencia suficiente para ver la curva de la demanda y atribuir el uso a una sesión, una VLAN o una clave. Cualquier detalle más específico debe considerarse una inferencia. La configuración que se describe a continuación explica qué fuente responde a cada pregunta, qué KPI merecen una alerta y cómo validar los datos en un centro antes de publicarlos de forma global.
Índice de contenidos
- Elija el método que coincida con su pregunta
- KPI que muestran la demanda, no solo el volumen
- Cómo configurar la medición en ocho pasos
- Muestreo frente a captura completa y qué cuesta cada uno
- Atribución del uso cuando la mayor parte del tráfico está cifrado
- Por qué sus cifras no coinciden y cómo reconciliarlas
- Valide en una ubicación antes de generar informes a nivel global
Elija el método que responda a su pregunta
Un grupo hotelero puede situarse en torno al 35 % de la capacidad del enlace ascendente a lo largo del día y, aun así, recibir quejas de los huéspedes todas las noches. La media respondía a una pregunta sobre capacidad. Los huéspedes planteaban una pregunta sobre las horas punta. La medición del uso del ancho de banda solo resulta útil cuando la fuente coincide con la pregunta, por lo que la mayoría de los centros necesitan dos fuentes de datos antes de trazar un gráfico. Una fuente sirve para los totales y la tendencia. La otra, para la atribución.
Rara vez necesitará hardware nuevo. Ya dispone de seis fuentes en los puntos de acceso, el controlador, el router y el servicio de autenticación.
| Fuente | Qué informa | Granularidad | Ideal para | Carga de procesamiento |
|---|---|---|---|---|
| Contadores de interfaz SNMP (ifHCInOctets, ifHCOutOctets) | Bytes entrantes y salientes por puerto o radio | Por interfaz, sondeados cada 1-5 minutos | Tendencia del enlace ascendente y planificación de capacidad | Baja |
| NetFlow v9 o IPFIX | Registros de flujo con origen, destino, puertos, bytes y paquetes | Por flujo, exportados habitualmente cada 1-5 minutos | Top talkers y quién habla con qué | Media, por la exportación y carga de CPU |
| sFlow | Cabeceras de paquetes muestreadas más contadores de interfaz | 1 de cada N paquetes, escalado a estimaciones | Enlaces rápidos (10G y superiores) y top talkers casi en tiempo real | Baja, el muestreo se ejecuta en hardware |
| Contadores por SSID y por VLAN | Bytes y número de clientes por red inalámbrica o VLAN | Por SSID, VLAN y punto de acceso | Carga de invitados frente a empleados y coste de tiempo de aire de cada SSID | Baja |
| Contabilidad RADIUS (Acct-Input-Octets, Acct-Output-Octets) | Bytes por sesión autenticada | Por sesión, actualizaciones intermadias cada 5-15 minutos | Atribuir el uso a un usuario, dispositivo o clave | Baja |
| Registros de DNS y DNS de protección | Consultas de dominio por directiva o categoría | Por consulta | Visibilidad a nivel de categoría sin inspección de carga útil | Baja a media |
Adapte el contador a la pregunta
Los contadores SNMP son la fuente primaria de datos totales. Sondee los objetos de 64 bits, ifHCInOctets e ifHCOutOctets. Un contador de octetos de 32 bits en un puerto de 1 Gbps se reinicia en unos 34 segundos a máxima velocidad, por lo que un sondeo de cinco minutos en el objeto antiguo genera deltas negativos o incoherentes. Los contadores por SSID muestran la carga de clientes y el coste de tiempo de aire de cada red inalámbrica. La contabilidad RADIUS vincula los bytes a un usuario, dispositivo o clave, sirviendo como fuente de atribución cuando la carga útil está cifrada.
La demanda móvil es lo suficientemente grande como para que, si se mezcla con el total de una ubicación fija, se oculte la limitación realmente importante. El tráfico global de internet alcanzó 1 zettabyte de tráfico de usuarios finales de banda ancha móvil en 2023, según la publicación Hechos y Cifras 2024 de la UIT. El enlace ascendente de un recinto y la ruta de descarga a red celular son mediciones distintas.
Elija una fuente principal de totales y una fuente de atribución para cada sede antes de configurar nada. Añadir una tercera fuente más adelante es sencillo. Desenredar dos fuentes sin etiquetar después de un mes no lo es.
KPI que muestran la demanda, no solo el volumen
Una línea base útil contabiliza el volumen total en el punto de acceso del usuario final, descargas y subidas combinadas, durante un periodo constante, normalmente un mes natural. Los metadatos de la Comisión Europea, extraídos de la metodología de la ITU, definen el tráfico de banda ancha fija de esa manera, y mantienen separado el tráfico de banda ancha móvil al excluir el tráfico mayorista y de jardín vallado. Ese límite también es importante en la red de un recinto. El uso de los clientes no es lo mismo que la capacidad de la red principal o el tráfico que nunca sale del operador.
Nombre el punto de medición en cada informe. Indique si se excluyen las tramas de gestión y control. Sin esos controles, dos sedes con los mismos usuarios no se podrán comparar.
Regla práctica: si un KPI no especifica el punto, la dirección, el intervalo de muestreo y el periodo, no está listo para generar alertas.
Fórmulas que puede comprobar manualmente
El rendimiento medio se calcula multiplicando el total de bytes por 8 y dividiéndolo por los segundos del periodo. El rendimiento pico es la muestra más alta de 1 o 5 minutos, no la media mensual. El percentil 95 ordena todas las muestras y toma el valor en el 95 %, de modo que una sola copia de archivos no determine el nivel de ocupación. El volumen de hora punta representa los bytes en la hora con mayor tráfico, y esa hora es la que determina el dimensionamiento. Los clientes activos concurrentes miden los dispositivos que transmitieron datos en el mismo intervalo. La utilización del tiempo de aire es la proporción de tiempo que el canal estuvo ocupado, obtenida de los contadores de radio del punto de acceso, y suele ser el límite inalámbrico mientras el enlace ascendente aún parece correcto. La cuota de enlace ascendente son los bytes de subida divididos por el total de bytes.
| KPI | Cómo calcularlo | Qué le indica | Ejemplo práctico |
|---|---|---|---|
| Volumen total | Suma de bytes de entrada y salida durante el periodo | Línea base de capacidad y tendencia mensual | 40 GB al día durante 30 días equivalen a 1,2 TB al mes |
| Rendimiento medio (Throughput) | Bytes x 8 divididos por segundos | Carga media | 40 GB al día equivalen a unos 3,7 Mbps de media |
| Rendimiento pico | Muestra más alta de 1 minuto o 5 minutos | Demanda puntual (picos de tráfico) | La muestra de 5 minutos con más tráfico en ese enlace ascendente |
| Rendimiento del percentil 95 | Ordenar muestras y tomar el valor al 95% | Nivel de actividad sostenido sin picos aislados | La marca del 95% a lo largo de un mes de sondeos de 5 minutos |
| Volumen en hora punta | Bytes en la hora de mayor tráfico | Dimensionamiento para la hora más crítica | 9 GB en la hora de las 21:00 |
| Clientes activos concurrentes | Clientes que transmiten datos en la misma ventana de muestra | Saturación y presión sobre el tiempo de aire (airtime) | 45 clientes transmitiendo datos en una ventana de 5 minutos |
| Uso del tiempo de aire (Airtime) | Tiempo de canal ocupado según los contadores de radio del AP | Congestión inalámbrica | Proporción de tiempo que el canal permanece ocupado |
| Cuota de subida | Bytes de subida divididos por los bytes totales | Videollamadas, copias de seguridad en la nube, cargas | 2 GB de subida de un total de 10 GB equivale al 20% |
Esas cifras calculadas son comprobaciones aritméticas, no un objetivo para sus sedes. Una sede con un promedio de 3.7 Mbps aún puede estar saturada durante una hora.
Alertas antes del panel
Establezca un umbral antes de enviar el primer informe. Un buen punto de partida es marcar cualquier ubicación cuyo percentil 95 se mantenga por encima del 80 % de la capacidad del enlace ascendente durante una hora punta completa, e investigar cualquier canal cuyo tiempo de aire permanezca elevado durante varias noches consecutivas. Ajuste ambos parámetros tras un mes de referencia. Genere informes por sitio, SSID y VLAN. Un promedio global de toda la infraestructura ocultará la instalación que está fallando, motivo por el cual una vista de uso por ubicación debe estar junto a los contadores sin procesar.
Antes de publicar una cifra, debería ser capaz de indicar en una sola frase su punto de medición, dirección, intervalo de muestreo y periodo.
Cómo configurar la medición en ocho pasos
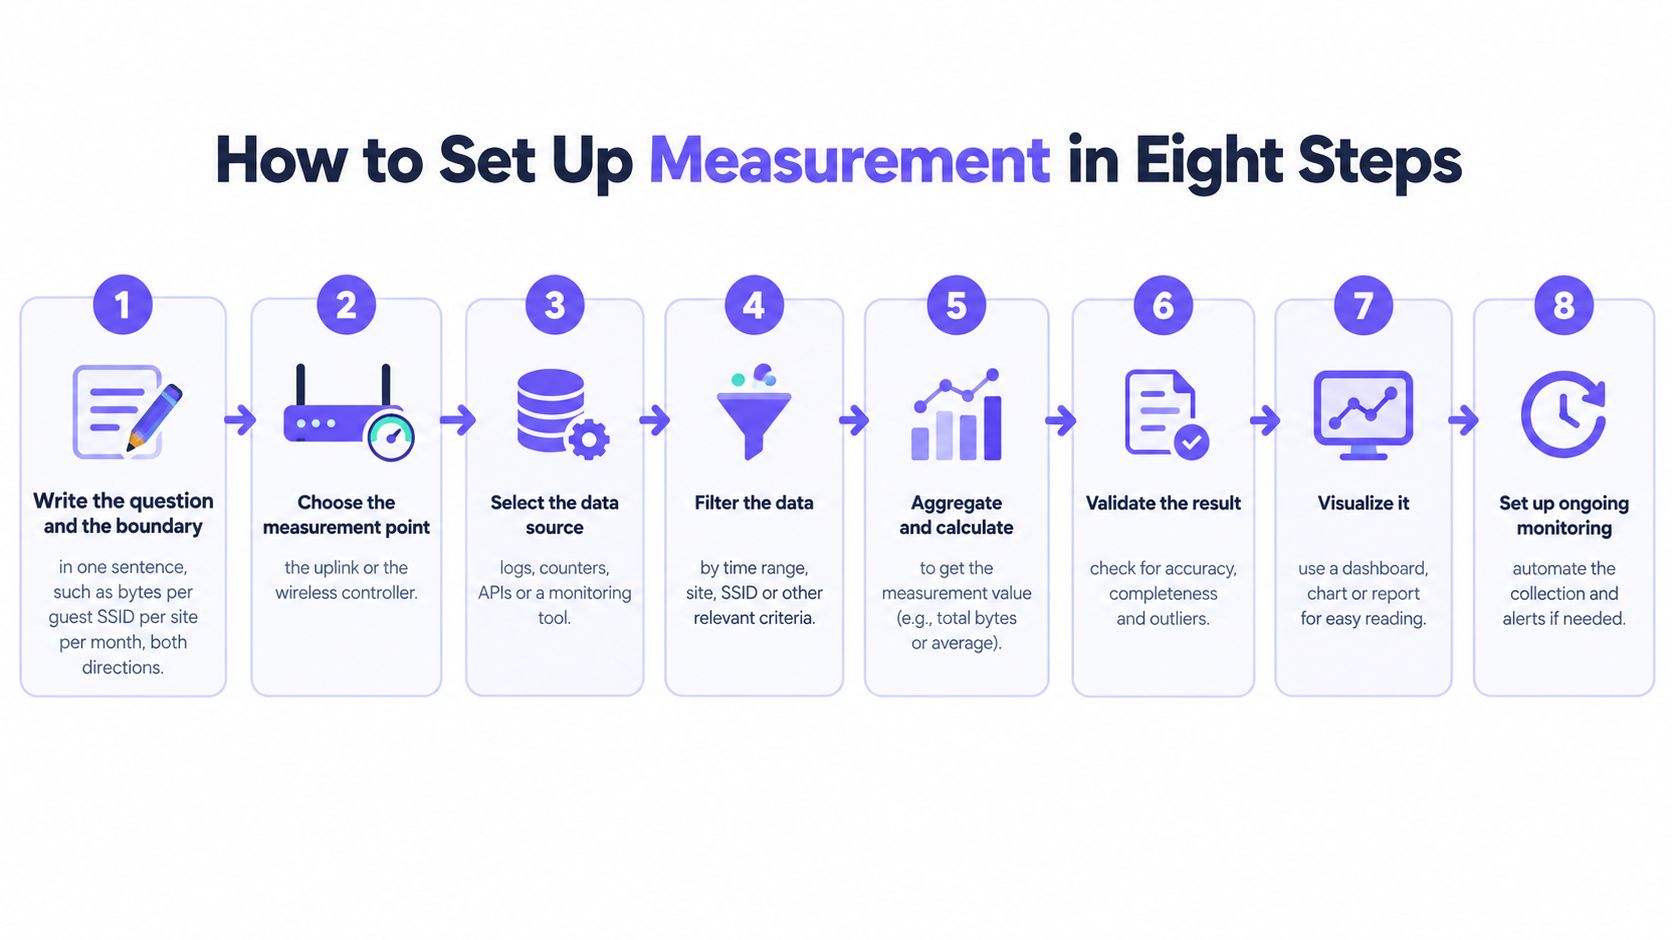
Diseñe el modelo de recopilación antes de tocar un dispositivo. Los ocho pasos a continuación son el mínimo necesario para sobrevivir a un año de cambios de personal y a una actualización de firmware.
Documéntelo y luego recopile
Escriba la pregunta y el límite en una sola frase. Ejemplo: bytes por SSID de invitado, por sitio, por mes, en ambas direcciones. Si la frase plantea dos preguntas, construirá dos informes a medio terminar. El error habitual es empezar desde una plantilla de panel en lugar de hacerlo desde la incidencia que está intentando explicar.
Seleccione el punto de medición. El enlace ascendente o el controlador inalámbrico proporcionan los totales. El enrutador central proporciona los flujos. El firewall perimetral solo proporciona el tráfico externo y no registrará las transferencias de LAN a LAN. No sume esos tres elementos. El error es tratarlos como duplicados de un solo número.
Habilite el sondeo de contadores de 64 bits. Utilice intervalos de 1 minuto en enlaces ascendentes muy ocupados e intervalos de 5 minutos para tendencias a largo plazo. Los datos de un minuto muestran el pico que un promedio de cinco minutos aplana. Sondear el objeto de 32 bits es el error que corrompe primero los puertos más ocupados.
Exporte los flujos a un colector. Establezca el tiempo de espera activo entre 1 y 5 minutos para que una sesión larga aparezca antes de que finalice. Sin ese tiempo de espera, parecerá que una videollamada no ha consumido nada hasta que el invitado se desconecte. Vigile el uso de CPU y las caídas de exportación en el enrutador. Un colector que se retrasa calcula por debajo de lo real de forma silenciosa.
Etiquete cada serie. El sitio, el SSID, la VLAN y el nombre del punto de acceso deben figurar en el registro cuando se almacene. Los datos sin etiquetar no se pueden segmentar más adelante, y cambiar el nombre de un SSID el próximo trimestre no corregirá el historial. El error es asumir que el nombre de host del dispositivo es una clave de sitio estable.
Active la contabilidad RADIUS con actualizaciones intermedias. Quince minutos es un intervalo práctico. Los registros intermedios mantienen visible una sesión larga y sobreviven a un cliente que nunca envía un cierre limpio. Si espera a la desconexión, las sesiones nocturnas desaparecerán del informe diario cada vez que se pierda el registro de parada.
Retención y una transferencia conocida
Defina la retención de forma deliberada. Conserve 13 meses de totales de 5 minutos para poder comparar la misma semana del año siguiente. Mantenga de 7 a 14 días de flujos sin procesar. El historial completo de flujos para cada ubicación cuesta más de lo que aporta. El error habitual es guardar flujos sin procesar indefinidamente porque nadie programó una tarea de borrado.
Valide con una transferencia conocida. Descargue un archivo de 10 GB en un dispositivo y confirme que los totales varíen aproximadamente en la misma cantidad, con un margen de pocos puntos porcentuales, en el contador seleccionado como principal. Realice esto antes de que alguien confíe en un gráfico. Omitir la validación es la razón por la que un contador desbordado o una exportación de flujo unidireccional terminan presentándose como un plan de capacidad.
Si el paso 8 falla, deténgase. Corrija el contador, el tiempo de espera (timeout) o la ruta faltante. No aplique la misma configuración en la siguiente sede.
Muestreo frente a captura completa y qué cuesta cada opción
Los totales proceden de contadores, los emisores principales provienen de flujos sin muestrear, los enlaces rápidos se muestrean y la captura completa se reserva para breves periodos de análisis forense. La precisión, el almacenamiento y la privacidad van en direcciones opuestas, por lo que utilizar un único método para cada consulta dará información errónea o llenará el disco.
| Enfoque | Precisión | Almacenamiento y sobrecarga | Exposición de privacidad | Ideal para |
|---|---|---|---|---|
| Contadores de interfaz sondeados cada 5 minutos | Totales exactos de bytes | Muy bajo | Ninguno | Totales, tendencias y comprobaciones de facturación |
| Registros de flujo sin muestrear (NetFlow o IPFIX) | Exacto por flujo, menos la pérdida de exportación | Moderado, aumenta con el número de flujos | Bajo, solo cabeceras | Principales generadores de tráfico e indicios de aplicaciones a nivel de puerto |
| sFlow de 1 en 1.000 a 1 en 4.000 paquetes | Estimación, menos precisa para flujos pequeños | Bajo | Bajo, cabeceras y carga útil truncada | Enlaces rápidos de 10G o superiores |
| Captura completa de paquetes | Exacto, cada paquete | Muy alto, varios TB por día en un enlace de 10G muy ocupado | Alto, puede contener datos personales | Ventanas forenses cortas durante incidentes |
Dónde falla cada método
Los contadores de interfaz ofrecen una precisión exacta para los bytes, pero no identifican quién los ha enviado. Utilícelos cuando una factura o un argumento sobre la capacidad deban ser justificables. No identificarán al emisor del tráfico.
NetFlow o IPFIX sin muestreo registra cada flujo, que es exactamente lo que se necesita para identificar a los usuarios o dispositivos con mayor consumo (top talkers). Las pérdidas en la exportación y un colector sobrecargado pueden seguir descartando registros en un router con mucho tráfico, por lo que la suma del flujo puede quedar por debajo del contador de la interfaz sin que haya ningún error de configuración en la coincidencia. Trate esa diferencia como una señal del estado del sistema, no como capacidad sin usar.
sFlow realiza muestreos por hardware, a menudo entre 1 de cada 1.000 y 1 de cada 4.000 paquetes en enlaces de acceso y núcleo, y después escala las muestras para ofrecer una estimación del volumen. Sigue siendo una opción económica en enlaces de 10G y más rápidos. Sin embargo, los flujos pequeños pueden desaparecer. La mensajería, el DNS y multitud de sesiones HTTPS cortas son precisamente los puntos donde la estimación es más débil, por lo que no debe facturarse a partir de sFlow ni utilizarse para demostrar el uso de un solo dispositivo.
La captura completa de paquetes es exacta, y en un enlace rápido de 10G a velocidad de línea puede generar varios terabytes al día. La carga útil puede contener datos personales que su directiva no le permite conservar.
Si la respuesta debe ser exacta para resolver una discrepancia, utilice contadores. Si solo necesita dar pistas sobre las aplicaciones, utilice registros de flujo solo con encabezados. Si se trata de un incidente puntual, realice una captura durante menos de una hora y detenga la captura cuando finalice el periodo.
Atribución del uso cuando la mayor parte del tráfico está cifrado
La inspección de carga útil es una base débil para identificar aplicaciones. Las mediciones recientes indican que HTTPS representó más del 95% de las solicitudes observadas a finales de 2025, según se informa en el resumen de Help Net Security sobre las tendencias de internet de Cloudflare para 2025. QUIC, DNS cifrado, CDN compartidas, VPN y las funciones de privacidad hacen que las etiquetas basadas en puertos sean aún menos fiables.
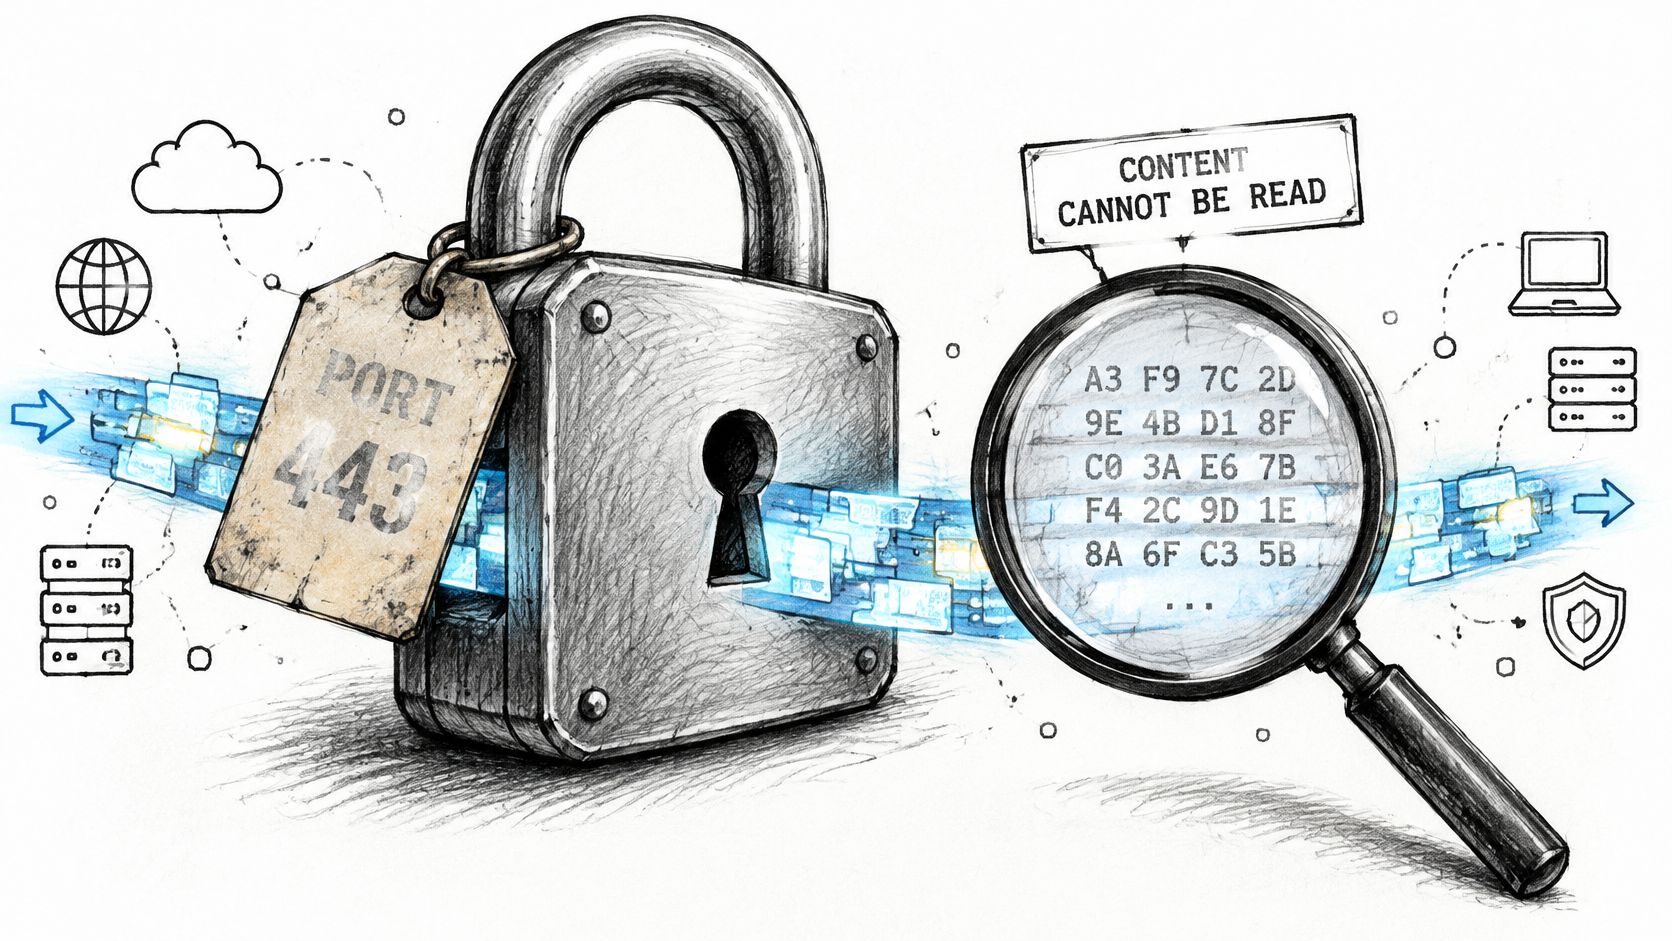
El tráfico cifrado no imposibilita la medición del uso del ancho de banda; simplemente cambia las evidencias. Es posible seguir midiendo bytes, paquetes, tiempos, dirección, número de conexiones, retransmisiones y latencia. Cuando la directiva lo permita, se puede añadir la categoría de destino o una identidad autenticada. Lo que no se puede afirmar es que la carga útil indique cuál era la aplicación.
Una arquitectura que indica su nivel de confianza
Construya la atribución a partir de registros que pueda defender.
- Bytes de sesión RADIUS (alta confianza): Acct-Input-Octets y Acct-Output-Octets vinculan el volumen a una sesión autenticada, un dispositivo o una clave xPSK. "Este dispositivo consumió 8 GB" puede ofrecer una alta confianza cuando la ruta de contabilidad está completa.
- Contadores por VLAN (alta confianza para el grupo): Invitados, personal, cajas registradoras e IoT se asignan a una VLAN, por lo que la carga del grupo no depende de descifrar nada.
- Categorías de directivas DNS (media y etiquetada): Los totales por categoría ofrecen una visibilidad similar a la de las aplicaciones. "El vídeo consumió 5 GB" es una inferencia. Indíquelo en el informe.
- Registros de flujo agregados (baja para el nombre de la aplicación): Las cabeceras siguen mostrando quién habló con qué dirección y cuántos bytes se movieron. Una dirección de CDN compartida no es una aplicación.
Las direcciones MAC aleatorias distorsionan el recuento de dispositivos. Un mismo teléfono puede parecer dos dispositivos diferentes con el paso de los días, lo que infla el total de clientes y divide sus bytes. Cuente las sesiones por persona o por clave cuando la directiva le proporcione esa identidad. Para una superficie comercial, la misma idea se aplica a la hora de separar el tráfico de los clientes del tráfico del personal en una misma radio, lo que forma parte de un diseño adecuado de retail WiFi design.
El balance de ventajas y desventajas se explica de forma sencilla en este breve recorrido.
Conserve los registros vinculados a identidades únicamente para la resolución de problemas, la planificación de capacidad y el cumplimiento normativo. Elimínelos de forma programada. Una etiqueta de confianza en cada cifra no cuesta nada y evita que una estimación por categorías termine tratándose como una factura.
Por qué sus cifras no coinciden y cómo reconciliarlas
El promedio mensual puede parecer saludable mientras los usuarios se quejan todas las tardes. Ambas afirmaciones suelen ser ciertas a la vez. El tráfico combinado de red fija y móvil también es un objetivo en constante cambio. Las estadísticas de tráfico de 2023 de la UIT sitúan el crecimiento medio anual entre 2019 y 2023 en torno al 30%, con el aumento más acusado al inicio de la pandemia en 2020. El crecimiento por sí solo no explica una mala tarde. La distribución del día, sí.
El informe de banda ancha del Q1 de 2025 de OpenVault demuestra por qué una simple media resulta engañosa para la planificación de capacidad. El uso medio por suscriptor en EE. UU. alcanzó los 663,2 GB al mes, un 9,5% más interanual, mientras que el uso de bajada en hora punta de las empresas subió un 21,2% y el de subida aumentó un 23,6%. La demanda de bajada empresarial registró su pico a la 1 p.m. La demanda residencial de subida y bajada alcanzó su pico sobre las 9 p.m. Un hotel o una propiedad residencial pueden parecer moderados en la gráfica mensual y, aun así, fallar a una hora predecible. Reducir los gigabytes mensuales no resuelve esa incidencia. Redistribuir la carga fuera de la hora punta, o corregir el tiempo de aire y la saturación, suele ayudar más a los huéspedes que ampliar el ancho de banda global.
Analice la discrepancia antes de comprar ancho de banda
| Síntoma | Causa probable | Comprobación |
|---|---|---|
| Los contadores muestran un 30 % de la capacidad, pero los invitados siguen quejándose | Las medias ocultan los picos nocturnos o la saturación de tiempo de aire (airtime contention) | Compare el percentil 95 en hora punta y la utilización del canal |
| Los totales de flujo están un 15 % por debajo de los contadores de interfaz | Error de muestreo, enrutamiento asimétrico o falta un exportador en una ruta | Compare en un enlace sin muestreo y confirme que cada ruta exporta flujos |
| Los totales por SSID no suman el total del AP | Tráfico de gestión excluido, o clientes en roaming a mitad del muestreo | Alinee las marcas de tiempo y confirme qué tramas incluye cada contador |
| Los totales de RADIUS superan el número de dispositivos | Sesiones duplicadas tras la reconexión o restablecimiento de contadores al reautenticar | Agrupe por ID de sesión y compruebe la gestión del restablecimiento |
| Una ubicación consume el doble que otra idéntica | Diferente combinación de usuarios, actualizaciones en caché o un error de etiquetado de VLAN | Desglose por VLAN y por las principales categorías de destino |
| El uso se dispara al día siguiente de un despliegue | Actualizaciones en la nube o se ha unido a la red una nueva clase de dispositivo | Compruebe las categorías de DNS y la hora exacta del despliegue |
Corrija primero la alineación temporal, luego el muestreo y después la atribución. Los errores posteriores se acumulan sobre los anteriores.
Una diferencia del doble entre sedes idénticas suele deberse a una etiqueta VLAN o a una combinación diferente de dispositivos, no a una aplicación misteriosa. Confirme el reloj, el exportador y la clave de sesión antes de reescribir el plan de capacidad. Un promedio a nivel de toda la organización no es un modelo válido para cada ubicación.
Valide en una sede antes de generar informes para toda la empresa
No aplique un nuevo diseño de medición a todas las instalaciones desde el primer día. Realice una prueba piloto en una sede representativa durante dos a cuatro semanas. La ventana debe incluir al menos una noche de mucha actividad y un día laborable tranquilo; de lo contrario, solo confirmará el promedio en el que ya no confía.
Mantenga la nueva recogida de datos en paralelo a la red que opera actualmente. No sustituya los contadores existentes hasta que las nuevas series coincidan con ellos, con un margen aproximado del 5 % en el total de bytes. La ejecución en paralelo es la mejor forma de detectar un contador reiniciado, un exportador que falta o una VLAN que nunca se llegó a etiquetar.
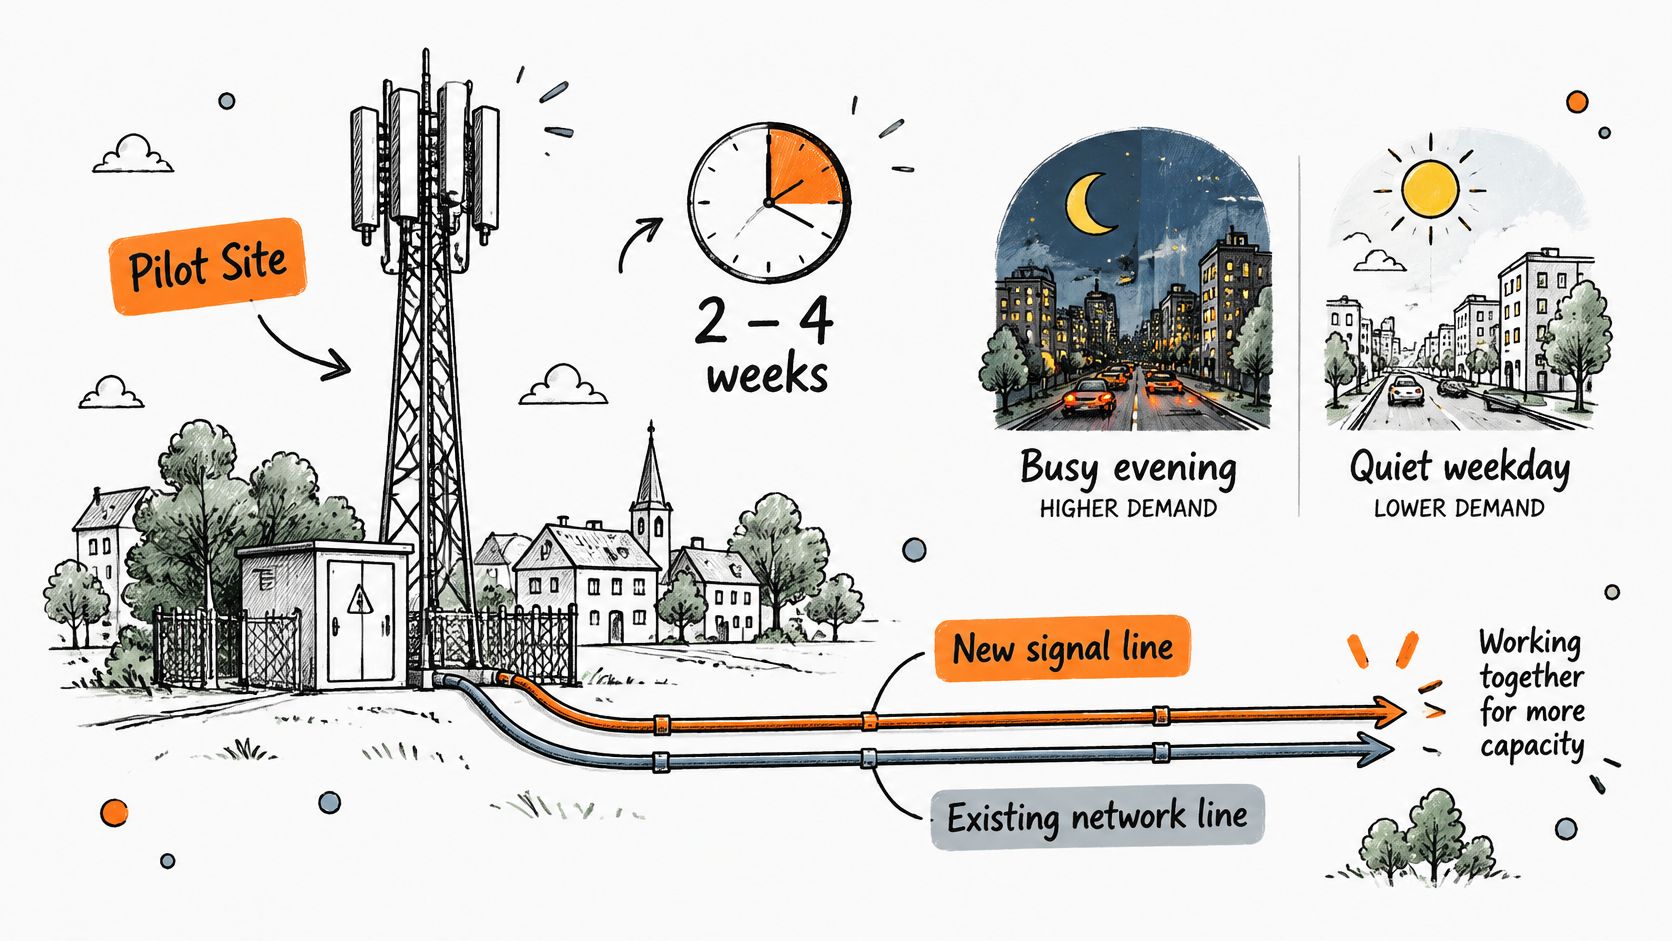
Evalúe el piloto en función de dos pruebas, no de lo completo que parezca el panel.
- Incidencias: ¿Coinciden las cifras de las horas punta con las quejas que ya tiene registradas? Si el gráfico se muestra estable durante la peor hora de la noche, el intervalo de muestreo o el punto de medición no son correctos.
- Auditoría: ¿Puede alguien responder a una pregunta concreta, como qué VLAN utilizó un dispositivo en un día determinado? Si el registro no permite responder a eso, la atribución no se ha completado.
Primero validamos el diseño en un sitio, en los puntos de acceso que ya tiene esa ubicación y junto a la red en producción; lo evaluamos mediante incidencias y evidencias de auditoría antes de realizar un despliegue más amplio. Una sesión de diseño de 45 minutos es suficiente para que un ingeniero mapee los SSID actuales en redes abiertas, seguras y xPSK sobre ese hardware, y usted conserva el plan. La monitorización del estado de la red permite profundizar desde toda la infraestructura hasta una ubicación y un equipo específico, ofreciendo pruebas de velocidad, tasas de autenticación y datos de descarga y comportamiento para que el uso indebido sea visible en lugar de especulativo. El plan de radio sigue debiendo ser sólido. Las mediciones no solucionarán una planificación de canales que nunca se diseñó, motivo por el cual el diseño de redes WiFi sigue siendo un trabajo independiente.
Establezca las reglas de generación de informes antes de incorporar la segunda ubicación. Utilice el mismo período y el mismo intervalo de muestreo en todas partes. Etiquete el nivel de confianza. Genere informes por ubicación, SSID y VLAN, y asigne un responsable a cada panel de control. Inicie el despliegue global solo cuando el piloto coincida con los contadores y el equipo pueda responder a sus tres preguntas principales con los datos obtenidos. Si no es así, vuelva a revisar las comprobaciones de desajustes. Ampliar una base de referencia defectuosa solo sirve para propagar el error más rápido.
Purple Access implementa redes abiertas, seguras y xPSK en los puntos de acceso que ya utiliza, con contabilidad RADIUS en la nube que puede vincular a un usuario, dispositivo o clave, además de vistas de estado que diferencian un promedio mensual tranquilo de una hora punta problemática. Pruébelo en una ubicación cotejándolo con sus tickets y su registro de auditoría antes de cambiar el resto de sus instalaciones. Descubra cómo se adapta a sus recintos en Purple Access.