
Medição de uso de largura de banda: métodos, KPIs e configuração
Published
Você gerencia um hotel, um campus ou uma rede de locais. O relatório mensal diz que o uplink é usado apenas parcialmente. Então a noite chega, a rede de convidados fica lenta e os chamados começam a aparecer. Essa discrepância é exatamente o resultado de uma medição de uso de largura de banda ineficiente quando ela se limita a um total mensal.
O volume médio é uma linha de base útil. Ele não descreve a hora de pico, a direção do tráfego ou qual grupo estava no ar às 21h. A criptografia piora o atalho antigo, pois os números de porta e a inspeção de carga útil não identificam mais o aplicativo com precisão.
O que ainda funciona é mais específico. Conte os bytes em ambas as direções em um ponto definido, faça amostragem com frequência suficiente para ver o padrão da demanda e atribua o uso a uma sessão, a uma VLAN ou a uma chave. Classifique qualquer detalhamento maior como uma inferência. A estrutura abaixo aborda qual fonte responde a qual pergunta, quais KPIs merecem um alerta e como comprovar os números em um local antes de publicá-los em todos os lugares.
Índice
- Escolha o método que corresponde à sua pergunta
- KPIs que mostram a demanda, não apenas o volume
- Como configurar a medição em oito etapas
- Amostragem versus captura total e o custo de cada uma
- Atribuindo o uso quando a maior parte do tráfego é criptografada
- Por que seus números não coincidem e como reconciliá-los
- Valide em um local antes de relatar para toda a empresa
Escolha o método que corresponde à sua dúvida
Um grupo hoteleiro pode operar com cerca de 35% da capacidade de uplink ao longo do dia e ainda assim receber reclamações de hóspedes todas as noites. A média respondeu a uma pergunta sobre capacidade. Os hóspedes estavam fazendo uma pergunta sobre o horário de pico. A medição de uso de largura de banda só ajuda quando a fonte corresponde à pergunta, portanto, a maioria dos locais precisa de duas fontes de dados antes de gerar um gráfico. Uma fonte é para totais e tendências. A outra é para atribuição.
Você raramente precisa de hardware novo. Seis fontes já estão presentes nos pontos de acesso, no controlador, no roteador e no serviço de autenticação.
| Fonte | O que reporta | Granularidade | Melhor para | Overhead |
|---|---|---|---|---|
| Contadores de interface SNMP (ifHCInOctets, ifHCOutOctets) | Bytes transmitidos e recebidos por porta ou rádio | Por interface, consultado a cada 1-5 minutos | Tendência de uplink e planejamento de capacidade | Baixo |
| NetFlow v9 ou IPFIX | Registros de fluxo com origem, destino, portas, bytes e pacotes | Por fluxo, normalmente exportado a cada 1-5 minutos | Maiores consumidores e quem se comunica com o quê | Médio, devido à exportação e carga de CPU |
| sFlow | Cabeçalhos de pacotes amostrados mais contadores de interface | 1 em cada N pacotes, ajustado para estimativas | Links rápidos (10G ou superior) e maiores consumidores em tempo quase real | Baixo, a amostragem roda via hardware |
| Contadores por SSID e por VLAN | Bytes e contagem de clientes por rede sem fio ou VLAN | Por SSID, VLAN e ponto de acesso | Carga de visitantes vs. funcionários e custo de tempo de ar de cada SSID | Baixo |
| Contabilidade RADIUS (Acct-Input-Octets, Acct-Output-Octets) | Bytes por sessão autenticada | Por sessão, atualizações intermediárias a cada 5-15 minutos | Atribuir uso a um usuário, dispositivo ou chave | Baixo |
| Logs de DNS e DNS de proteção | Consultas de domínio por política ou categoria | Por consulta | Visão no nível de categoria sem inspeção de carga útil | Baixo a médio |
Associe o contador à pergunta
Os contadores SNMP são a fonte dos totais. Colete os objetos de 64 bits, ifHCInOctets e ifHCOutOctets. Um contador de octetos de 32 bits em uma porta de 1 Gbps reinicia em cerca de 34 segundos em capacidade máxima, de modo que uma pesquisa de cinco minutos no objeto antigo gera deltas negativos ou incorretos. Os contadores por SSID mostram a carga do cliente e o custo de airtime de cada rede sem fio. O RADIUS accounting vincula bytes a um usuário, dispositivo ou chave, que é a fonte de atribuição quando as cargas úteis estão criptografadas.
A demanda móvel é grande o suficiente para que, ao ser misturada ao total de um local fixo, esconda o gargalo que realmente importa. O tráfego global de internet atingiu 1 zettabyte de tráfego de usuário final em banda larga móvel em 2023, de acordo com o relatório ITU Facts and Figures 2024. Um uplink de um local e uma rota de offload celular são medições totalmente diferentes.
Escolha uma fonte principal para totais e uma fonte de atribuição para cada local antes de configurar qualquer coisa. Adicionar um terceiro feed mais tarde é fácil. Desfazer a confusão de dois feeds sem rótulo após um mês não é.
KPIs que mostram a demanda, não apenas o volume
Uma linha de base útil conta o volume total no ponto de acesso do usuário final, downloads e uploads somados, durante um período consistente, geralmente um mês de calendário. Os metadados da Comissão Europeia, extraídos da metodologia da ITU, definem o tráfego de banda larga fixa dessa forma e mantêm o tráfego de banda larga móvel separado, excluindo o tráfego de atacado e de walled garden. Esse limite também é importante em uma rede de local físico. O uso do cliente não é a mesma coisa que a capacidade de backbone ou tráfego que nunca sai da operadora.
Nomeie o ponto de medição em cada relatório. Informe se os quadros de gerenciamento e controle estão excluídos. Sem esses controles, dois locais com os mesmos usuários não poderão ser comparados.
Regra prática: Se um KPI não especifica o ponto, a direção, o intervalo de amostragem e o período, ele não está pronto para acionar alertas.
Fórmulas que você pode verificar manualmente
A taxa de transferência média (throughput) é o total de bytes multiplicado por 8 e dividido pelos segundos do período. A taxa de transferência de pico é a maior amostra de 1 minuto ou 5 minutos, não a média mensal. O 95º percentil ordena todas as amostras e pega o valor em 95%, garantindo que uma única cópia de arquivo não defina o nível de pico. O volume no horário de pico são os bytes na hora mais movimentada, e é essa hora que você usa para o dimensionamento. Clientes ativos concorrentes conta os dispositivos que trafegaram dados na mesma janela. A utilização de tempo de antena (airtime) é a fração de tempo em que o canal esteve ocupado, obtida dos contadores de rádio do ponto de acesso, e geralmente é o limite do sinal sem fio enquanto o uplink ainda parece bom. A participação de upload são os bytes de upload divididos pelo total de bytes.
| KPI | Como calcular | O que isso indica | Exemplo prático |
|---|---|---|---|
| Volume total | Soma dos bytes de entrada e saída no período | Linha de base de capacidade e tendência mensal | 40 GB por dia ao longo de 30 dias equivalem a 1,2 TB por mês |
| Throughput médio | Bytes x 8 divididos por segundos | Carga média | 40 GB por dia equivalem a cerca de 3,7 Mbps em média |
| Throughput de pico | Amostra mais alta de 1 minuto ou 5 minutos | Demanda de picos pontuais | A amostra de 5 minutos mais movimentada nesse uplink |
| Throughput no percentil 95 | Ordene as amostras e pegue o valor a 95% | Nível de pico sustentado sem picos raros | A marca de 95% ao longo de um mês de pesquisas de 5 minutos |
| Volume no horário de pico | Bytes no horário de maior tráfego | Dimensionamento para o pior horário | 9 GB no horário das 21h |
| Clientes ativos concorrentes | Clientes transmitindo dados na mesma janela de amostragem | Contenção e pressão sobre o airtime | 45 clientes transmitindo dados em uma janela de 5 minutos |
| Utilização de airtime | Tempo de canal ocupado a partir dos contadores de rádio do AP | Congestionamento do WiFi | Proporção de tempo em que o canal permanece ocupado |
| Proporção de upstream | Bytes de upstream divididos pelo total de bytes | Chamadas de vídeo, backup em nuvem, uploads | 2 GB de upstream de um total de 10 GB equivalem a 20% |
Estes valores calculados são verificações aritméticas, não uma meta para os seus locais. Um local com média de 3,7 Mbps ainda pode ficar saturado por uma hora.
Alertas antes do painel
Defina um limite antes que o primeiro relatório seja enviado. Um bom começo é sinalizar qualquer local cujo 95º percentil permaneça acima de 80% da capacidade do uplink durante uma hora de pico inteira, e investigar qualquer canal cujo tempo de antena permaneça alto durante noites consecutivas. Ajuste ambos após um mês de linha de base. Gere relatórios por local, SSID e VLAN. Uma média única de toda a infraestrutura ocultará o local que está apresentando falhas, e é por isso que uma visualização de uso por local deve estar ao lado dos contadores brutos.
Antes de publicar um número, você deve ser capaz de declarar seu ponto de medição, direção, intervalo de amostragem e período em uma única frase.
Como configurar a medição em oito etapas
Elabore o projeto de coleta antes de tocar em qualquer dispositivo. As oito etapas abaixo são o mínimo necessário para resistir a um ano de trocas de equipe e a uma atualização de firmware.
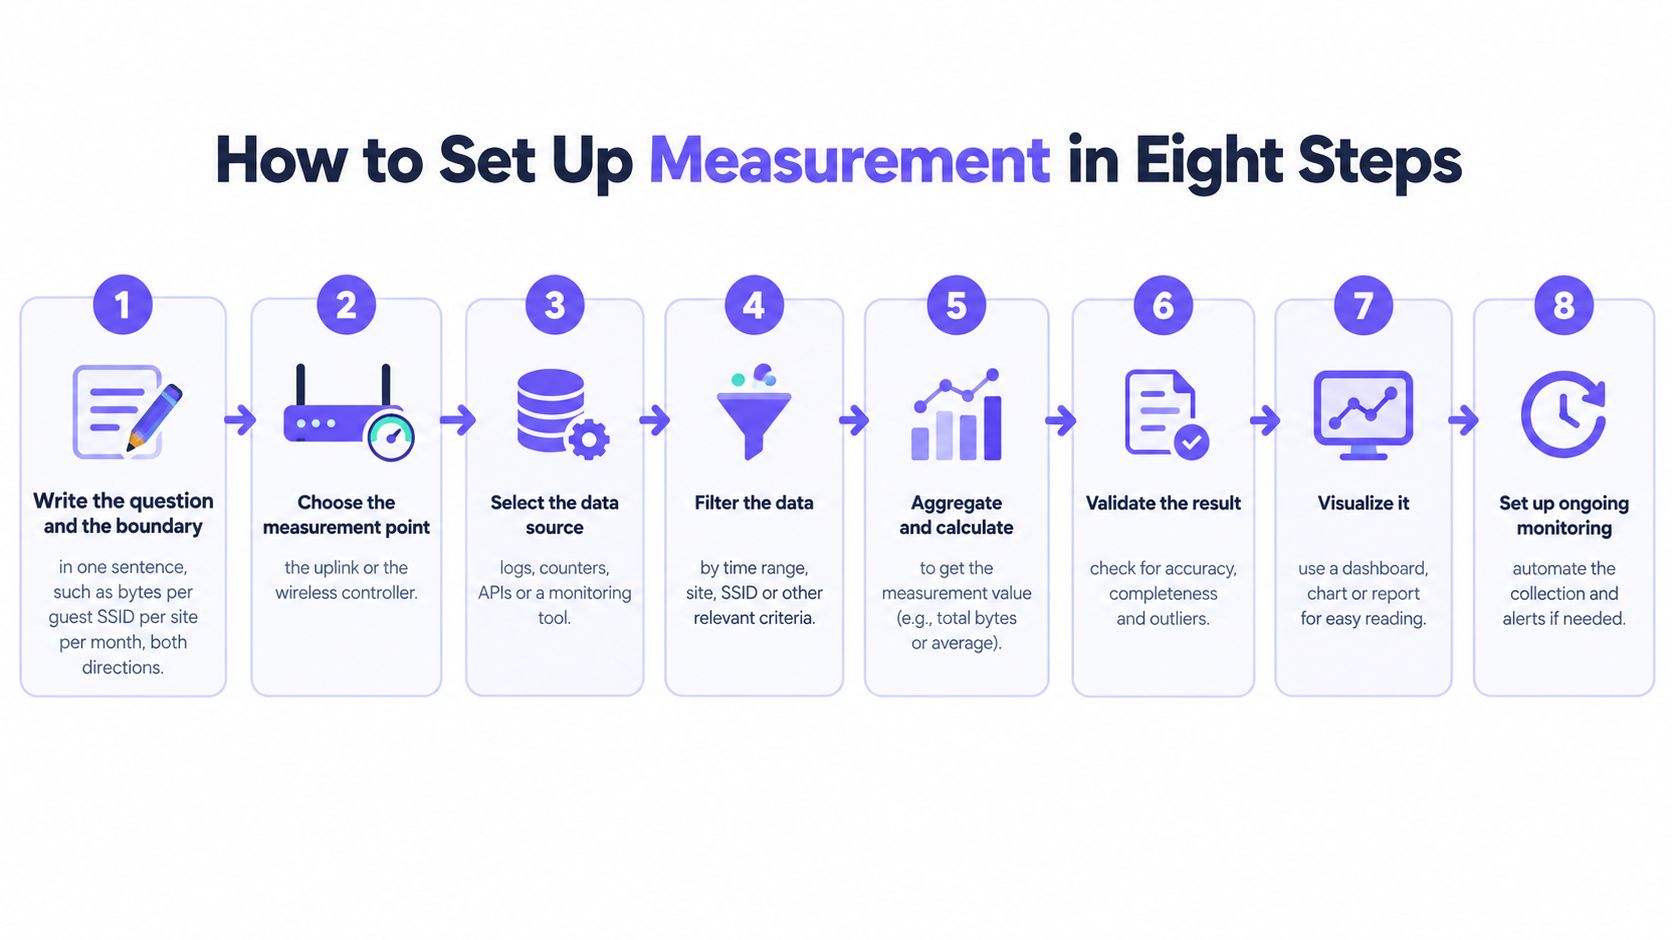
Documente primeiro, depois colete
Escreva a pergunta e o limite em uma frase. Exemplo: bytes por SSID de convidado, por local, por mês, em ambas as direções. Se a frase citar duas perguntas, você criará dois relatórios incompletos. O erro comum é começar a partir de um modelo de painel em vez do chamado que você está tentando explicar.
Escolha o ponto de medição. O uplink ou o controlador sem fio fornece os totais. O roteador principal fornece os fluxos. O firewall de borda fornece apenas o tráfego externo e não registrará as transferências LAN-to-LAN. Não some esses três elementos. O erro é tratá-los como duplicatas de um único número.
Habilite a sondagem de contadores de 64 bits. Use intervalos de 1 minuto em uplinks movimentados e intervalos de 5 minutos para tendências de longo prazo. Os dados de um minuto mostram o pico que uma média de cinco minutos suaviza. Fazer a sondagem do objeto de 32 bits é o erro que corrompe primeiro as portas mais movimentadas.
Exporte fluxos para um coletor. Defina o tempo limite ativo de 1 a 5 minutos para que uma sessão longa apareça antes de ser encerrada. Sem esse tempo limite, uma chamada de vídeo parecerá não ter consumido nada até que o convidado se desconecte. Monitore a CPU e as perdas de exportação no roteador. Um coletor que fica atrasado reduz silenciosamente a contagem.
Marque cada série de dados. O local, o SSID, a VLAN e o nome do ponto de acesso devem estar no registro quando ele for armazenado. Dados sem marcação não podem ser segmentados posteriormente, e renomear um SSID no próximo trimestre não corrigirá o histórico. O erro é presumir que o hostname do dispositivo é uma chave de local estável.
Ative a contabilidade RADIUS com atualizações interinas. Quinze minutos é um intervalo prático. Registros interinos mantêm uma sessão longa visível e sobrevivem a um cliente que nunca envia um encerramento limpo. Se você esperar pela desconexão, as sessões noturnas desaparecerão do relatório diário sempre que o sinal de parada for perdido.
Retenção e uma transferência conhecida
Defina a retenção intencionalmente. Mantenha 13 meses de totais de 5 minutos para poder comparar a mesma semana no ano seguinte. Mantenha de 7 a 14 dias de fluxos brutos. O histórico completo de fluxo para cada local custa mais do que traz de benefícios. O erro comum é manter fluxos brutos para sempre porque ninguém configurou uma tarefa de exclusão.
Valide com uma transferência conhecida. Faça o download de um arquivo de 10 GB em um dispositivo e confirme se os totais mudam aproximadamente na mesma quantidade, com variação de poucos pontos percentuais, no contador escolhido como principal. Faça isso antes que alguém confie em um gráfico. Ignorar a validação é como um contador reiniciado ou uma exportação de fluxo unidirecional acaba virando um plano de capacidade.
Se a etapa 8 falhar, pare. Corrija o contador, o timeout ou o caminho ausente. Não aplique a mesma configuração no próximo local.
Amostragem versus captura completa e o custo de cada uma
Os totais vêm de contadores, os principais transmissores vêm de fluxos não amostrados, os links rápidos são amostrados e a captura completa é para janelas forenses curtas. Precisão, armazenamento e privacidade se movem em direções opostas, portanto, usar um único método para todas as questões vai gerar dados incorretos ou lotar o disco.
| Abordagem | Precisão | Armazenamento e Sobrecarga | Exposição de Privacidade | Ideal para |
|---|---|---|---|---|
| Contadores de interface consultados a cada 5 minutos | Totais exatos de bytes | Muito pequeno | Nenhuma | Totais, verificação de tendências e faturamento |
| Registros de fluxo sem amostragem (NetFlow ou IPFIX) | Exato por fluxo, menos perdas de exportação | Moderado, cresce com a contagem de fluxos | Baixa, apenas cabeçalhos | Principais geradores de tráfego e dicas de aplicações em nível de porta |
| sFlow de 1 em 1.000 a 1 em 4.000 pacotes | Estimativa, menor para fluxos pequenos | Baixo | Baixa, cabeçalhos e carga útil truncada | Links rápidos de 10G ou superior |
| Captura completa de pacotes | Exata, cada pacote | Muito alto, vários TB por dia em um link de 10G movimentado | Alta, pode conter dados pessoais | Janelas forenses curtas durante incidentes |
Onde cada método falha
Contadores de interface são exatos para bytes, mas não identificam quem os enviou. Use-os quando uma fatura ou discussão de capacidade precisar ser justificável. Eles não identificarão o transmissor.
O NetFlow ou IPFIX sem amostragem registra todos os fluxos, o que é o ideal para identificar os maiores transmissores (top talkers). A perda de exportação e um coletor sobrecarregado ainda podem descartar registros em um roteador ocupado, portanto, a soma dos fluxos pode ficar abaixo do contador da interface sem que ninguém tenha desconfigurado o mapeamento. Trate essa diferença como um sinal de integridade do sistema, não como capacidade não utilizada.
O sFlow faz amostragem via hardware, frequentemente em torno de 1 em 1.000 a 1 em 4.000 pacotes em links de acesso e core, e depois dimensiona as amostras em uma estimativa de volume. Ele permanece viável financeiramente em links de 10G ou mais rápidos. Fluxos pequenos podem desaparecer. Mensagens, DNS e uma infinidade de sessões HTTPS curtas são exatamente onde a estimativa é mais fraca, portanto não fature com base no sFlow e não o use para comprovar o uso de um único dispositivo.
A captura completa de pacotes é exata e, em um link de 10G movimentado em taxa de linha, pode produzir vários terabytes por dia. A carga útil pode conter dados pessoais que sua política não permite reter.
Se a resposta precisa ser exata para uma disputa, use contadores. Se ela deve apenas indicar aplicativos, use registros de fluxo contendo apenas cabeçalhos. Se for um incidente isolado, faça a captura por menos de uma hora e pare a captura quando a janela fechar.
Como atribuir o uso quando a maior parte do tráfego é criptografada
A inspeção de carga útil (payload inspection) é uma base fraca para nomear aplicações. Medições recentes indicam que o HTTPS representava mais de 95% das solicitações observadas até o final de 2025, conforme relatado no resumo das tendências de internet de 2025 da Cloudflare publicado pela Help Net Security. QUIC, DNS criptografado, CDNs compartilhadas, VPNs e recursos de privacidade tornam os rótulos baseados em portas ainda menos confiáveis.
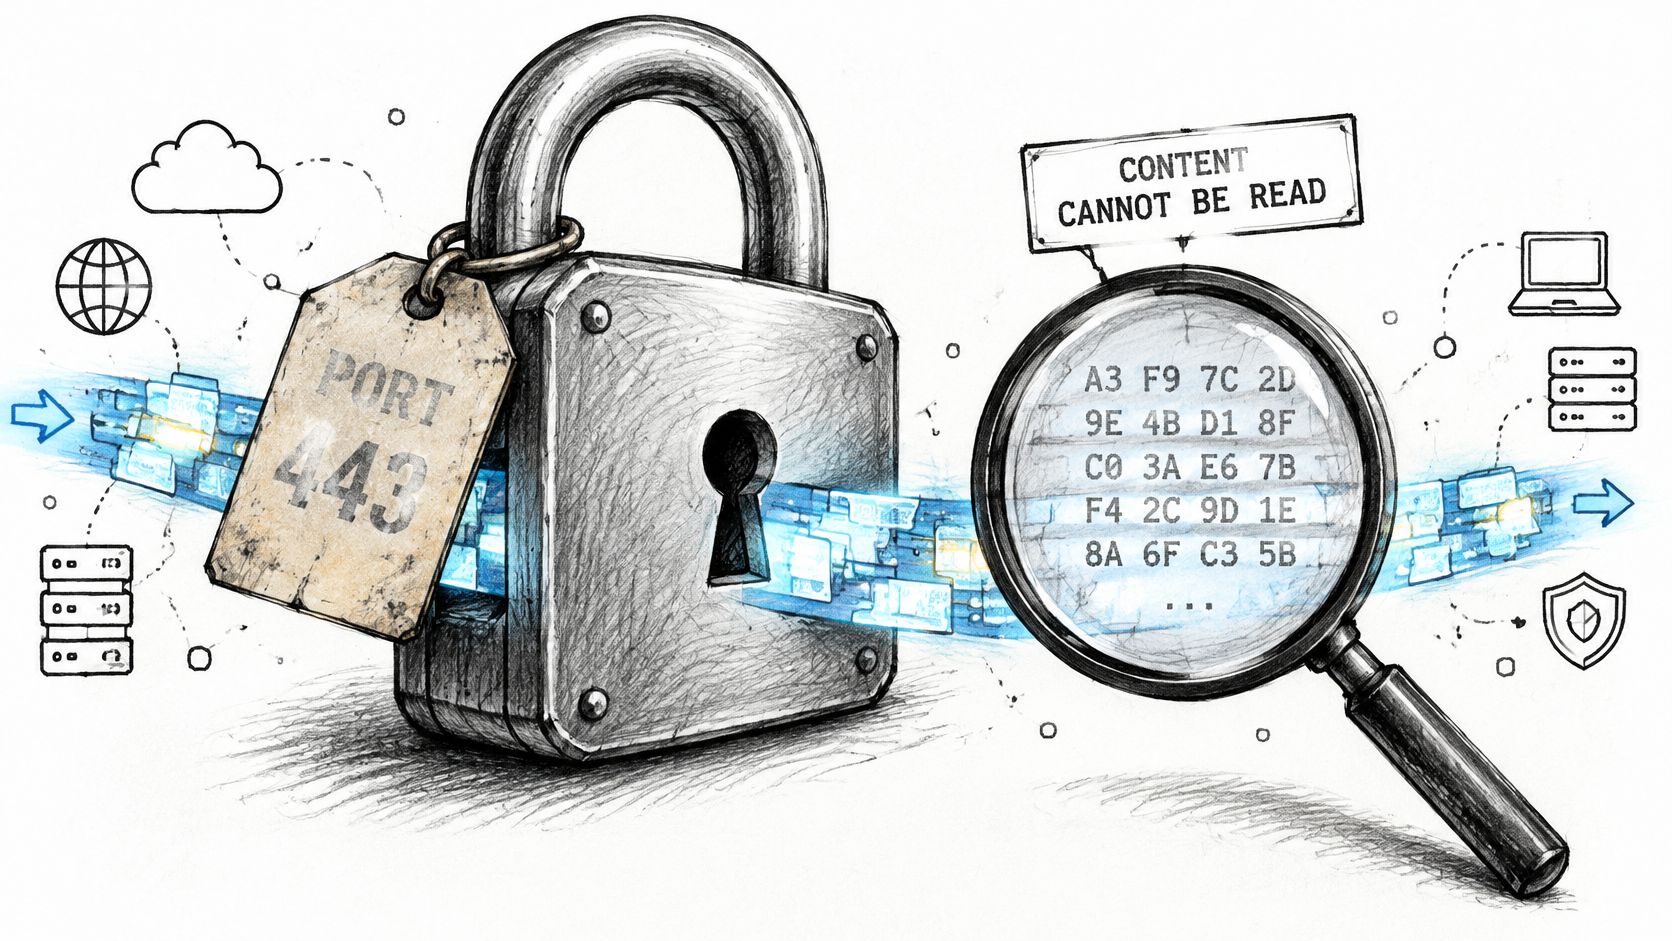
O tráfego criptografado não torna a medição de uso de largura de banda impossível. Ele apenas altera as evidências. Você ainda pode medir bytes, pacotes, tempo, direção, contagem de conexões, retransmissões e latência. Onde a política permitir, você pode adicionar a categoria de destino ou uma identidade autenticada. No entanto, você não pode afirmar que o conteúdo do pacote revelou a aplicação.
Uma estrutura que declara seu nível de confiança
Construa a atribuição a partir de registros que você possa defender.
- Bytes de sessão RADIUS (alta confiança): Acct-Input-Octets e Acct-Output-Octets vinculam o volume a uma sessão autenticada, um dispositivo ou uma chave xPSK. "Este dispositivo consumiu 8 GB" pode ter alta confiança quando o caminho de contabilidade está completo.
- Contadores por VLAN (alta confiança para o grupo): Visitante, equipe, caixas e IoT ficam cada um em uma VLAN, portanto, a carga do grupo não depende da descriptografia de nada.
- Categorias de política DNS (média e rotulada): Os totais por categoria oferecem percepções semelhantes às de aplicativos. "Vídeo consumiu 5 GB" é uma inferência. Informe isso no relatório.
- Registros de fluxo agregados (baixa para o nome do aplicativo): Os cabeçalhos ainda mostram quem se comunicou com qual endereço e quantos bytes foram transferidos. Um endereço de CDN compartilhado não é um aplicativo.
Endereços MAC aleatórios distorcem a contagem de dispositivos. Um único telefone pode parecer dois dispositivos diferentes ao longo dos dias, o que infla o total de clientes e divide seus bytes. Conte as sessões por pessoa ou por chave quando a política fornecer essa identidade. Para um ambiente de varejo, essa mesma ideia se aplica à forma como você separa o tráfego de clientes do tráfego de funcionários em um rádio compartilhado, o que faz parte de um projeto consistente de WiFi para varejo.
O equilíbrio entre as opções em termos simples está neste breve passo a passo.
Mantenha registros vinculados à identidade apenas para solução de problemas, planejamento de capacidade e conformidade. Exclua-os de acordo com um cronograma. Adicionar um rótulo de confiabilidade a cada número não custa nada e evita que uma suposição de categoria seja tratada como uma fatura.
Por que seus números não coincidem e como reconciliá-los
A média mensal pode parecer saudável enquanto os usuários se queixam todas as noites. Ambas as afirmações são frequentemente verdadeiras. O tráfego combinado fixo e móvel também é um alvo em constante mudança. As estatísticas de tráfego de 2023 da ITU apontam um crescimento médio anual de 2019 a 2023 de cerca de 30%, com o aumento mais acentuado no início da pandemia em 2020. O crescimento por si só não explica uma noite ruim. O comportamento do tráfego ao longo do dia, sim.
O relatório de banda larga do 1º trimestre de 2025 da OpenVault mostra por que uma única média induz ao erro no planejamento de capacidade. O uso médio de assinantes nos EUA atingiu 663,2 GB por mês, um aumento de 9,5% ano a ano, enquanto o uso de downstream para empresas no horário de pico subiu 21,2% e o uso de upstream subiu 23,6%. A demanda de downstream empresarial atingiu o pico às 13h. A demanda residencial de upstream e downstream atingiu o pico por volta das 21h. Um hotel ou uma propriedade residencial pode parecer modesto no gráfico mensal e ainda assim falhar em um horário previsível. Reduzir gigabytes mensais não resolve essa reclamação. Mover a carga para fora do horário de pico, ou corrigir o airtime e a contenção, geralmente ajuda mais os hóspedes do que um link agregado maior.
Analise a divergência antes de comprar largura de banda
| Sintoma | Causa provável | Verificação |
|---|---|---|
| Os contadores mostram 30% da capacidade, mas os visitantes ainda se queixam | As médias ocultam picos noturnos ou contenção de tempo de transmissão | Compare o percentil 95 do horário de pico e a utilização do canal |
| Os totais de fluxo estão 15% abaixo dos contadores de interface | Erro de amostragem, roteamento assimétrico ou falta de um exportador em um dos caminhos | Compare em um link sem amostragem e confirme se todos os caminhos exportam fluxos |
| Os totais por SSID não somam o total do AP | Tráfego de gerenciamento excluído ou clientes em roaming no meio da amostragem | Alinhe os carimbos de data/hora e confirme quais quadros cada contador inclui |
| Os totais do RADIUS excedem a contagem de dispositivos | Sessões duplicadas após reconexão ou contadores reiniciados na reautenticação | Agrupe por ID de sessão e verifique o tratamento de reinicialização |
| Um local usa o dobro do tráfego de um local idêntico | Mistura de usuários diferente, atualizações em cache ou erro de marcação de VLAN | Detalhe por VLAN e pelas principais categorias de destino |
| O uso aumenta no dia seguinte à implementação | Atualizações em nuvem ou uma nova classe de dispositivo conectou-se à rede | Verifique as categorias do DNS e o horário exato da implementação |
Corrija o alinhamento de tempo primeiro, depois a amostragem e, por fim, a atribuição. Erros posteriores agravam os anteriores.
Uma diferença de duas vezes entre locais idênticos geralmente é uma tag de VLAN ou uma combinação diferente de dispositivos, não um aplicativo misterioso. Confirme o relógio, o exportador e a chave de sessão antes de reescrever o plano de capacidade. Uma média para toda a organização não é um modelo para cada local.
Valide em um local antes de relatar para toda a empresa
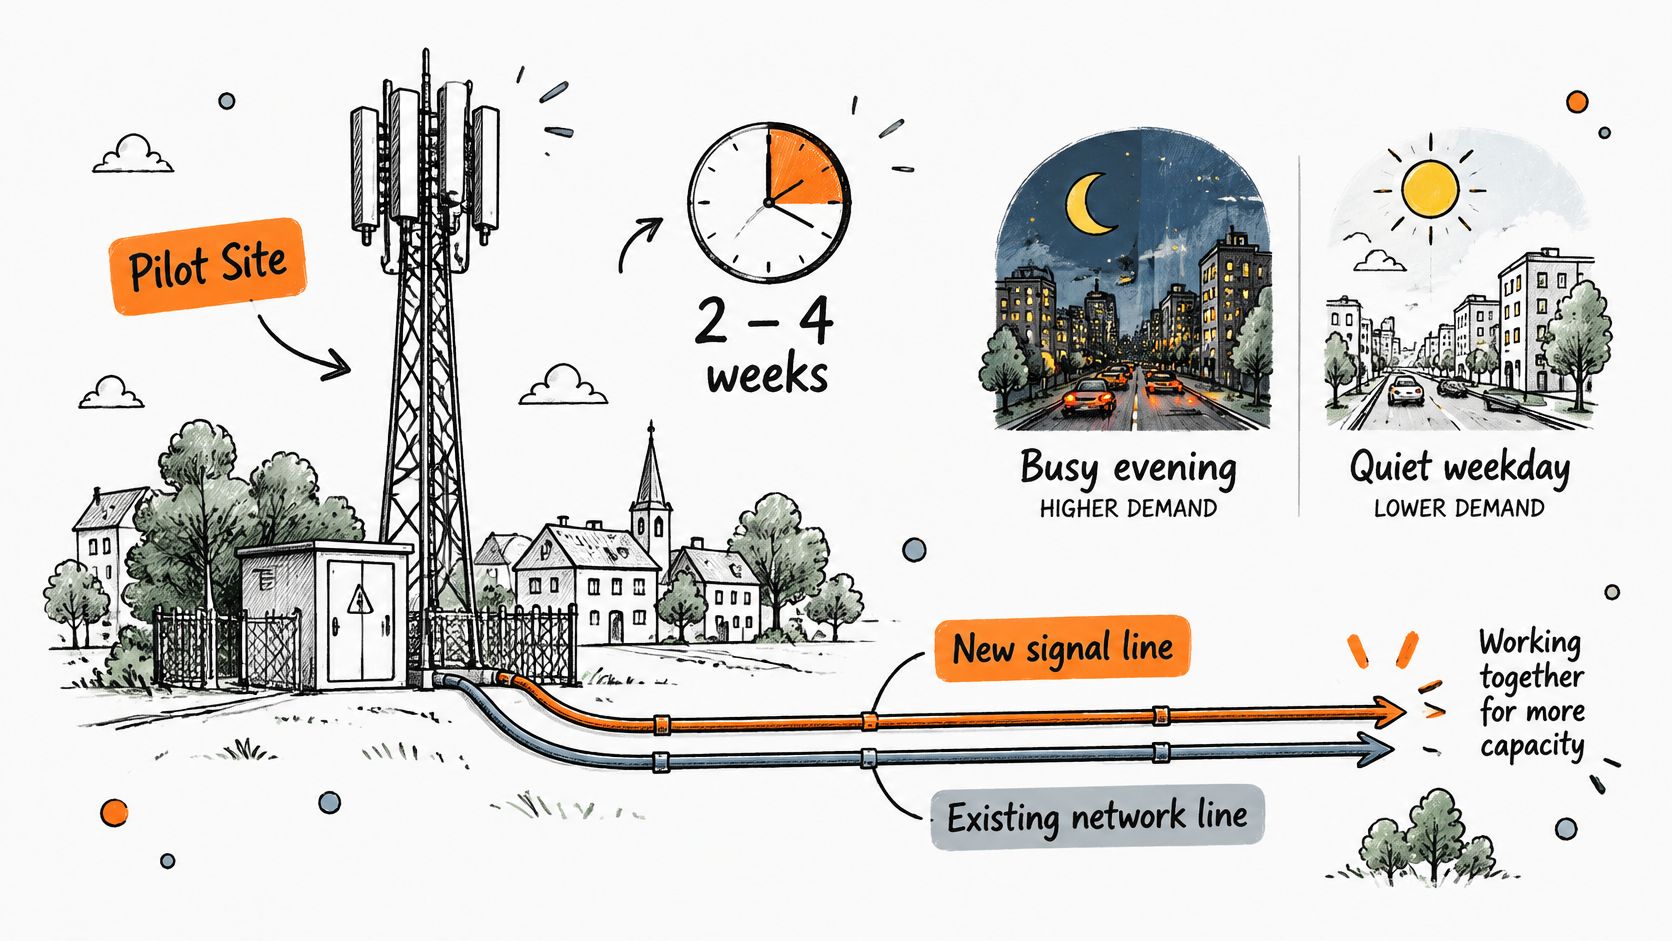
Não aplique um novo modelo de medição para todas as propriedades no primeiro dia. Execute um piloto em um local representativo por duas a quatro semanas. A janela deve incluir pelo menos uma noite movimentada e um dia útil calmo, caso contrário, você apenas confirmará a média na qual já não confia.
Mantenha a nova coleta ao lado da rede que você opera hoje. Não substitua os contadores existentes até que as novas séries coincidam com eles, com uma margem de variação de cerca de 5% no total de bytes. Uma execução em paralelo é a forma de identificar um contador reiniciado, um exportador ausente ou uma VLAN que nunca foi etiquetada.
Avalie o piloto com base em dois testes, e não no grau de conclusão do painel.
- Chamados: Os números do horário de pico coincidem com as reclamações que você já possui? Se o gráfico estiver calmo durante a pior noite, o intervalo de amostragem ou o ponto de medição está incorreto.
- Auditoria: Alguém consegue responder a uma pergunta real, como qual VLAN um dispositivo usou em um determinado dia? Se o histórico não puder responder a isso, a atribuição não está concluída.
Nós provamos uma arquitetura em um local primeiro, nos pontos de acesso que esse local já possui, ao lado da rede em operação, e a avaliamos com base em chamados e evidências de auditoria antes de uma implantação mais ampla. Uma sessão de projeto de 45 minutos é suficiente para que um engenheiro mapeie os SSIDs atuais em redes abertas, seguras e xPSK nesse hardware, e você mantém o planejamento. O monitoramento de integridade da rede detalha desde toda a infraestrutura até um local e um equipamento específico, com testes de velocidade, taxas de autenticação, downloads e dados comportamentais para que o uso indevido seja visível em vez de presumido. O planejamento de rádio ainda precisa ser sólido. A medição não vai reparar um plano de canais que nunca foi projetado, e é por isso que o projeto de rede WiFi permanece como uma etapa separada do trabalho.
Defina as regras de relatório antes do segundo local. Use o mesmo período e o mesmo intervalo de amostragem em todos os lugares. Indique o nível de confiabilidade. Gere relatórios por local, SSID e VLAN, e atribua um responsável para cada painel. Faça a implantação somente quando o piloto estiver em conformidade com os contadores e a equipe conseguir responder às suas três principais perguntas com base nos dados. Se não conseguir, volte às verificações de divergência. Expandir uma linha de base com falhas apenas acelera a propagação do erro.
O Purple Access oferece acesso aberto, seguro e xPSK nos access points que você já utiliza, com bilhetagem RADIUS em nuvem que você pode vincular a um usuário, dispositivo ou chave, além de exibições de integridade que diferenciam uma média mensal tranquila de um horário de pico problemático. Comprove isso em um local comparando com seus chamados e sua trilha de auditoria antes de alterar o restante da infraestrutura. Veja como isso se adapta aos seus locais em Purple Access.