Medição da Utilização de Largura de Banda: Métodos, KPIs e Configuração
Published
Gere um hotel, um campus ou uma cadeia de espaços. O relatório mensal diz que o uplink está apenas parcialmente utilizado. Depois chega a noite, a rede de convidados fica lenta e os tickets aparecem na mesma. Essa discrepância é o aspeto de uma bandwidth usage measurement deficiente quando se fica apenas pelo total mensal.
O volume médio é uma linha de base útil. Não descreve a hora de ponta, a direção do tráfego ou que grupo estava no ar às 21h. A encriptação piora o antigo atalho, porque os números de porta e a inspeção de carga útil já não identificam a aplicação com confiança.
O que continua a funcionar é mais restrito. Conte os bytes em ambas as direções num ponto identificado, recolha amostras com frequência suficiente para ver o perfil da procura e atribua a utilização a uma sessão, a uma VLAN ou a uma chave. Classifique tudo o que for mais detalhado como uma inferência. A configuração abaixo aborda qual a fonte que responde a cada pergunta, quais os KPIs que merecem um alerta e como provar os números num local antes de os publicar em todo o lado.
Índice
- Escolha o método adequado à sua questão
- KPIs que mostram a procura, não apenas o volume
- Como configurar a medição em oito passos
- Amostragem versus captura total e o custo de cada uma
- Atribuir a utilização quando a maioria do tráfego é encriptado
- Por que motivo os seus números diferem e como reconciliá-los
- Valide num único local antes de apresentar relatórios para toda a empresa
Escolha o Método Que Corresponde à Sua Questão
Um grupo hoteleiro pode ter cerca de 35% de capacidade de uplink ao longo do dia e, ainda assim, receber reclamações dos hóspedes todas as noites. A média respondeu a uma questão de capacidade. Os hóspedes estavam a fazer uma pergunta sobre a hora de ponta. A bandwidth usage measurement só ajuda quando a fonte se adequa à pergunta, pelo que a maioria dos locais precisa de duas fontes de dados antes de desenhar um gráfico. Uma fonte serve para totais e tendências. A outra serve para atribuição.
Raramente precisa de hardware novo. Já existem seis fontes nos pontos de acesso, no controlador, no router e no serviço de autenticação.
| Fonte | O Que Reporta | Granularidade | Ideal Para | Sobrecarga |
|---|---|---|---|---|
| Contadores de interface SNMP (ifHCInOctets, ifHCOutOctets) | Bytes recebidos e enviados por porta ou rádio | Por interface, consultados a cada 1-5 minutos | Tendência de uplink e planeamento de capacidade | Baixa |
| NetFlow v9 ou IPFIX | Registos de fluxo com origem, destino, portas, bytes e pacotes | Por fluxo, tipicamente exportados a cada 1-5 minutos | Principais utilizadores e quem comunica com o quê | Média, devido à exportação e carga de CPU |
| sFlow | Cabeçalhos de pacotes amostrados e contadores de interface | 1 em cada N pacotes, escalado para estimativas | Ligações rápidas (10G ou superior) e principais utilizadores em tempo quase real | Baixa, a amostragem é executada no hardware |
| Contadores por SSID e por VLAN | Bytes e número de clientes por rede sem fios ou VLAN | Por SSID, VLAN e ponto de acesso | Carga de convidados versus colaboradores e custo de tempo de antena de cada SSID | Baixa |
| Contabilidade RADIUS (Acct-Input-Octets, Acct-Output-Octets) | Bytes por sessão autenticada | Por sessão, atualizações intermédias a cada 5-15 minutos | Atribuir utilização a um utilizador, dispositivo ou chave | Baixa |
| Registos de DNS e DNS de proteção | Consultas de domínio por política ou categoria | Por consulta | Análise ao nível da categoria sem inspeção de conteúdo | Baixa a média |
Associe o contador à questão
Os contadores SNMP são a fonte dos totais. Monitorize os objetos de 64 bits, ifHCInOctets e ifHCOutOctets. Um contador de octetos de 32 bits numa porta de 1 Gbps reinicia em cerca de 34 segundos à velocidade máxima, pelo que uma amostragem de cinco minutos no objeto antigo inventa deltas negativos ou sem sentido. Os contadores por SSID mostram a carga de clientes e o custo de tempo de antena de cada rede sem fios. A contabilidade RADIUS vincula bytes a um utilizador, a um dispositivo ou a uma chave, sendo a fonte de atribuição quando os dados estão encriptados.
A procura móvel é suficientemente grande para que a sua inclusão no total de um local fixo oculte a limitação que realmente importa. O tráfego global de internet atingiu 1 zettabyte de tráfego de utilizador final em banda larga móvel em 2023, de acordo com os Factos e Dados de 2024 da ITU. O uplink de um local e um caminho de offload celular são medições diferentes.
Escolha uma fonte primária de totais e uma fonte de atribuição para cada local antes de configurar qualquer coisa. Adicionar uma terceira fonte mais tarde é fácil. Desembaraçar duas fontes sem etiqueta após um mês não é.
KPIs Que Mostram a Procura, Não Apenas o Volume
Uma referência utilizável mede o volume total no ponto de acesso do utilizador final, downloads e uploads somados, durante um período consistente, geralmente um mês de calendário. Os metadados da Comissão Europeia, baseados na metodologia da ITU, definem o tráfego de banda larga fixa dessa forma, e mantêm o tráfego de banda larga móvel separado ao excluir o tráfego grossista e de jardim murado. Essa limitação também é importante numa rede de local físico. A utilização do cliente não é a mesma coisa que a capacidade do backbone ou o tráfego que nunca sai do operador.
Nomeie o ponto de medição em cada relatório. Indique se as tramas de gestão e controlo estão excluídas. Sem esses controlos, dois locais com os mesmos utilizadores não poderão ser comparados.
Regra prática: Se um KPI não indicar o ponto, a direção, o intervalo de amostragem e o período, não está pronto para acionar alertas.
Fórmulas que pode verificar manualmente
O débito médio é o total de bytes multiplicado por 8, depois dividido pelos segundos no período. O débito de pico é a amostra mais alta de 1 minuto ou 5 minutos, não a média mensal. O percentil 95 ordena cada amostra e apanha o valor a 95%, para que uma única cópia de ficheiro não defina o nível de atividade. O volume na hora de ponta corresponde aos bytes na hora individual mais alta, sendo essa a hora utilizada para o dimensionamento. Os clientes ativos concorrentes contam os dispositivos que transmitiram dados na mesma janela. A utilização de tempo de antena é a fração de tempo em que o canal esteve ocupado, obtida a partir dos contadores de rádio do ponto de acesso, e é frequentemente o limite do sem-fios enquanto o uplink ainda parece saudável. A fração de upstream é dada pelos bytes de upstream divididos pelo total de bytes.
| KPI | Como calcular | O que lhe indica | Exemplo prático |
|---|---|---|---|
| Volume total | Soma de bytes recebidos e enviados durante o período | Linha de base de capacidade e tendência mensal | 40 GB por dia ao longo de 30 dias é igual a 1,2 TB por mês |
| Throughput médio | Bytes x 8 divididos por segundos | Carga média | 40 GB por dia equivalem a cerca de 3,7 Mbps em média |
| Throughput de pico | Amostra mais elevada de 1 minuto ou 5 minutos | Procura de pico | A amostra de 5 minutos mais movimentada nessa ligação ascendente |
| Throughput do percentil 95 | Ordenar amostras e obter o valor a 95% | Nível de atividade sustentado sem picos raros | |
| Volume da hora de ponta | Bytes na hora de maior tráfego | Dimensionamento para a pior hora | 9 GB na hora das 21:00 |
| Clientes ativos concorrentes | Clientes a transmitir dados na mesma janela de amostragem | Contenção e pressão no tempo de antena (airtime) | 45 clientes a transmitir dados numa janela de 5 minutos |
| Utilização do tempo de antena (airtime) | Tempo de canal ocupado a partir dos contadores de rádio do AP | Congestionamento sem fios | Percentagem de tempo que o canal permanece ocupado |
| Percentagem de upstream | Bytes de upstream divididos pelo total de bytes | Chamadas de vídeo, cópias de segurança na nuvem, carregamentos | 2 GB de upstream num total de 10 GB é igual a 20% |
Estes valores calculados são verificações aritméticas, não uma meta para os seus locais. Um local com uma média de 3.7 Mbps pode na mesma estar saturado durante uma hora.
Alertas antes do painel
Defina um limite antes de enviar o primeiro relatório. Um bom ponto de partida é sinalizar qualquer local cujo percentil 95 permaneça acima de 80% da capacidade do uplink durante uma hora de ponta completa, e investigar qualquer canal cujo tempo de antena se mantenha elevado ao longo de noites consecutivas. Ajuste ambos após um mês de referência. Apresente relatórios por local, SSID e VLAN. Uma média global da infraestrutura vai ocultar a propriedade que está a falhar, razão pela qual uma vista de utilização por local deve estar ao lado dos contadores em bruto.
Antes de publicar um número, deve ser capaz de indicar o seu ponto de medição, direção, intervalo de amostragem e período numa única frase.
Como Configurar a Medição em Oito Passos
Elabore o plano de recolha antes de tocar num dispositivo. Os oito passos abaixo são o mínimo para resistir a um ano de mudanças de pessoal e a uma atualização de firmware.
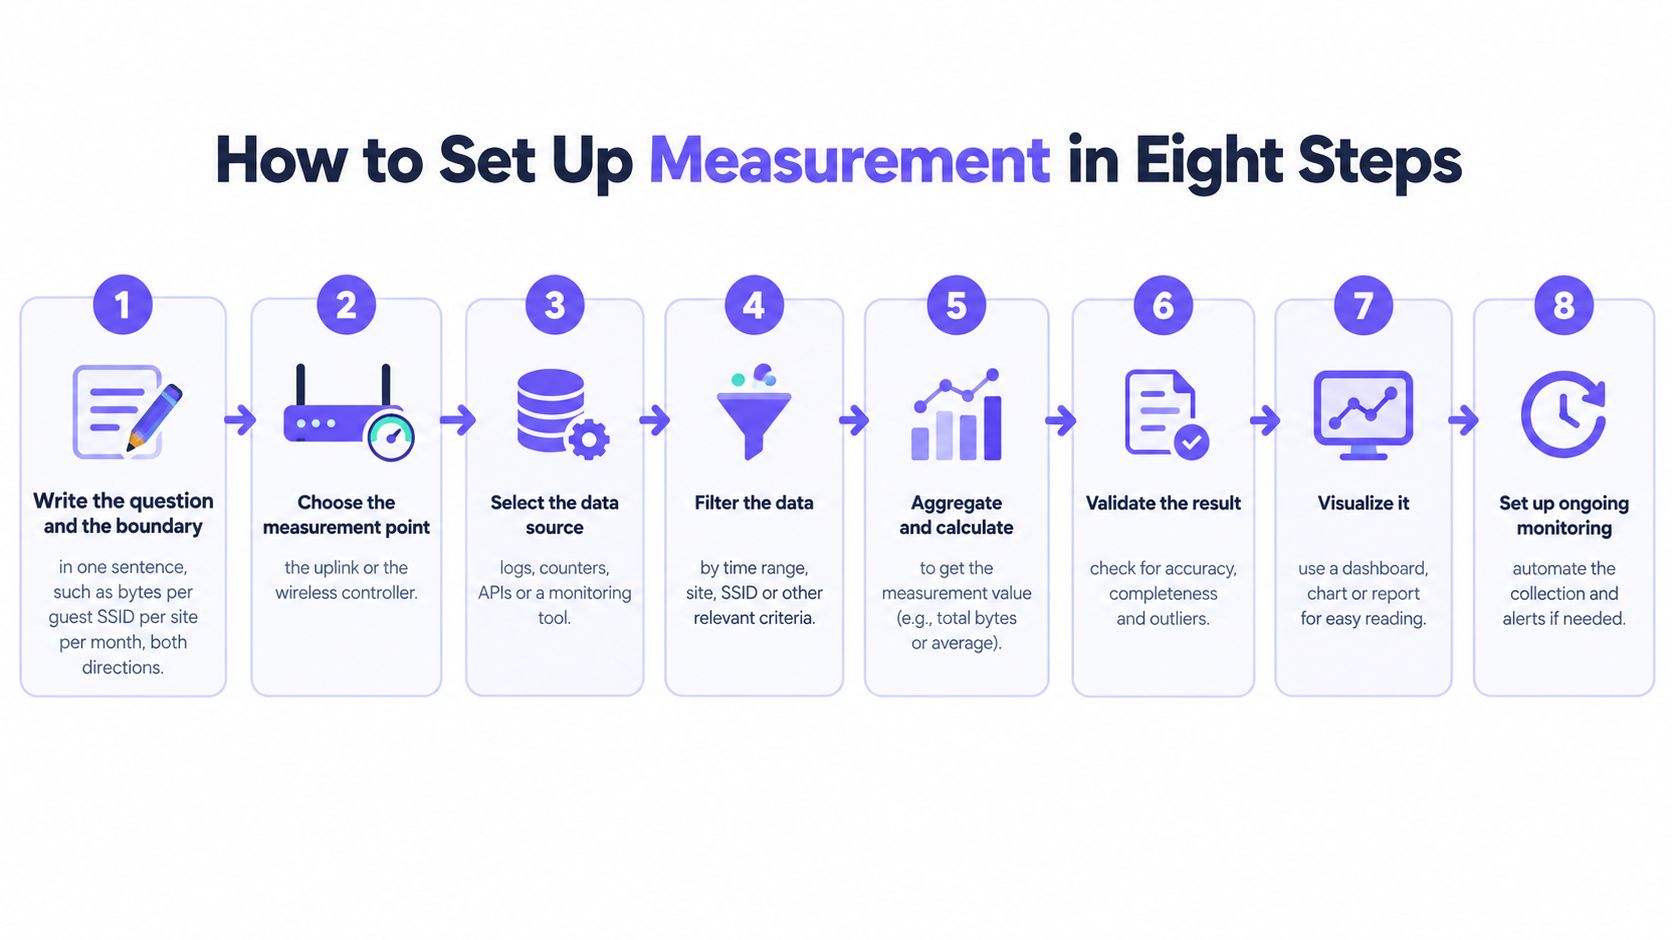
Documente primeiro, recolha depois
Escreva a pergunta e o limite numa única frase. Exemplo: bytes por SSID de convidado, por local, por mês, em ambas as direções. Se a frase nomear duas perguntas, irá criar dois relatórios inacabados. O erro comum é começar a partir de um modelo de painel em vez do pedido que está a tentar explicar.
Escolha o ponto de medição. O uplink ou o controlador sem fios fornece os totais. O router central fornece os fluxos. O firewall de periferia fornece apenas o tráfego externo e não irá registar transferências LAN-para-LAN. Não some estes três elementos. O erro consiste em tratá-los como duplicados de um único número.
Ative a sondagem de contadores de 64 bits. Utilize intervalos de 1 minuto em uplinks ocupados e intervalos de 5 minutos para tendências de longo prazo. Os dados de um minuto mostram o pico que uma média de cinco minutos suaviza. A sondagem do objeto de 32 bits é o erro que corrompe primeiro as portas mais ocupadas.
Exporte fluxos para um coletor. Defina o tempo limite ativo para 1-5 minutos para que uma sessão longa apareça antes de terminar. Sem esse tempo limite, uma chamada de vídeo parece não ter consumido nada até o convidado desligar. Monitorize a CPU e as perdas de exportação no router. Um coletor que fique para trás reduz silenciosamente a contagem.
Etiquete todas as séries. O local, SSID, VLAN e o nome do ponto de acesso têm de estar no registo quando este for armazenado. Os dados não etiquetados não podem ser divididos mais tarde, e alterar o nome de um SSID no próximo trimestre não irá reparar o histórico. O erro é assumir que o hostname do dispositivo é uma chave de local estável.
Ative a contabilidade RADIUS com atualizações intermédias. Quinze minutos é um intervalo prático. Os registos intermédios mantêm uma sessão longa visível e sobrevivem a um cliente que nunca envia um fecho limpo. Se esperar pelo desligamento, as sessões noturnas desaparecem do relatório diário sempre que o fecho se perde.
Retenção e uma transferência conhecida
Defina a retenção intencionalmente. Guarde 13 meses de totais de 5 minutos para poder comparar a mesma semana no ano seguinte. Guarde 7 a 14 dias de fluxos em bruto. O histórico completo de fluxos para cada local custa mais do que os conhecimentos que fornece. O erro comum é guardar fluxos em bruto para sempre porque ninguém configurou uma tarefa de eliminação.
Valide com uma transferência conhecida. Faça o download de um ficheiro de 10 GB num dispositivo e confirme que os totais variam aproximadamente na mesma quantidade, dentro de uma margem de poucos por cento, no contador que definiu como principal. Faça isto antes que alguém confie num gráfico. Ignorar a validação é a razão pela qual um contador com overflow ou uma exportação de fluxo unidirecional acabam por ser apresentados como um plano de capacidade.
Se o passo 8 falhar, pare. Corrija o contador, o tempo limite ou o caminho em falta. Não aplique a mesma configuração no local seguinte.
Amostragem Versus Captura Total e Quanto Custa Cada Uma
Os totais vêm de contadores, os maiores consumidores vêm de fluxos não amostrados, as ligações rápidas são amostradas e a captura total destina-se a breves janelas forenses. Precisão, armazenamento e privacidade movem-se em direções opostas, pelo que um único método para todas as questões irá mentir ou encher o disco.
| Abordagem | Precisão | Armazenamento e Overhead | Exposição da Privacidade | Melhor Para |
|---|---|---|---|---|
| Contadores de interface sondados a cada 5 minutos | Totais exatos de bytes | Muito reduzido | Nenhuma | Totais, tendências e verificações de faturação |
| Registos de fluxo sem amostragem (NetFlow ou IPFIX) | Exato por fluxo, menos perdas de exportação | Moderado, cresce com a contagem de fluxos | Baixa, apenas cabeçalhos | Principais utilizadores e pistas de aplicações ao nível da porta |
| sFlow a 1 em 1.000 até 1 em 4.000 pacotes | Estimativa, mais fraca para fluxos pequenos | Baixo | Baixa, cabeçalhos e carga útil truncada | Ligações rápidas de 10G e superiores |
| Captura total de pacotes | Exata, todos os pacotes | Muito elevado, vários TB por dia numa ligação 10G ocupada | Elevada, pode conter dados pessoais | Janelas forenses curtas durante incidentes |
Onde cada método falha
Contadores de interface são exatos para bytes e omissos sobre quem os enviou. Utilize-os quando uma fatura ou um argumento de capacidade tiver de ser defensável. Eles não vão identificar quem está a transmitir.
O NetFlow ou IPFIX sem amostragem regista todos os fluxos, que é o que deseja para os maiores utilizadores. Perdas na exportação e um coletor sobrecarregado continuam a descartar registos num router ocupado, pelo que a soma do fluxo pode ficar abaixo do contador da interface sem que ninguém tenha configurado mal a correspondência. Trate essa diferença como um sinal de estado de saúde, não como capacidade não utilizada.
O sFlow recolhe amostras no hardware, frequentemente cerca de 1 em 1 000 a 1 em 4 000 pacotes em ligações de acesso e core, e depois dimensiona as amostras para uma estimativa de volume. Permanece económico em ligações de 10G e mais rápidas. Fluxos pequenos podem desaparecer. Mensagens, DNS e uma multidão de sessões HTTPS curtas são exatamente onde a estimativa é mais fraca, por isso não fature a partir do sFlow nem o utilize para provar a utilização de um único dispositivo.
A captura completa de pacotes é exata e, numa ligação 10G movimentada à velocidade da linha, pode produzir vários terabytes por dia. A carga útil pode conter dados pessoais que a sua política não permite reter.
Se a resposta tiver de ser exata para uma disputa, utilize contadores. Se tiver de indicar aplicações, utilize registos de fluxo apenas com cabeçalhos. Se for um incidente pontual, capture durante menos de uma hora e pare a captura quando a janela terminar.
Atribuir a Utilização Quando a Maior Parte do Tráfego Está Encriptada
A inspeção de payload é uma base fraca para identificar aplicações. Medições recentes indicam que o HTTPS representava mais de 95% dos pedidos observados até ao final de 2025, conforme relatado no resumo da Help Net Security sobre as tendências de internet da Cloudflare para 2025. QUIC, DNS encriptado, CDNs partilhados, VPNs e funcionalidades de privacidade tornam os rótulos baseados em portas ainda menos fiáveis.
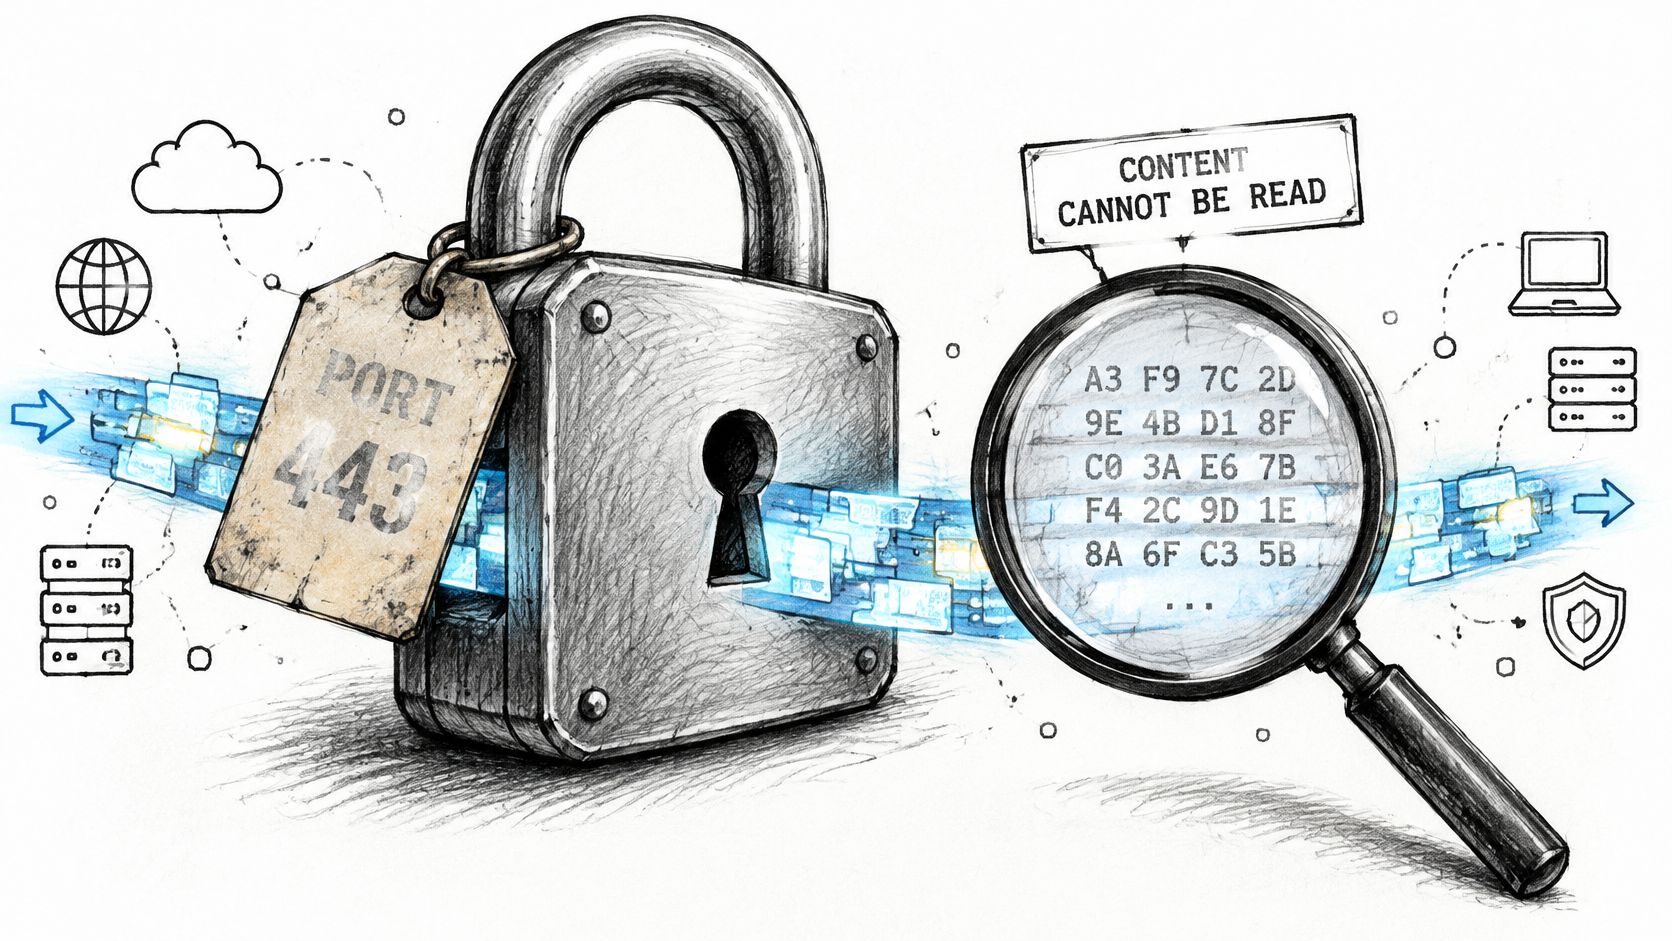
O tráfego encriptado não torna a bandwidth usage measurement impossível. Altera as provas. Continua a ser possível medir bytes, pacotes, temporização, direção, contagem de ligações, retransmissões e latência. Onde a política o permitir, pode adicionar a categoria de destino ou uma identidade autenticada. Não pode afirmar que o conteúdo útil (payload) lhe indicou a aplicação.
Uma arquitetura que indica o seu grau de confiança
Construa a atribuição a partir de registos que possa defender.
- Bytes de sessão RADIUS (alta confiança): Acct-Input-Octets e Acct-Output-Octets associam o volume a uma sessão autenticada, a um dispositivo ou a uma chave xPSK. "Este dispositivo consumiu 8 GB" pode ser uma informação de alta confiança quando o caminho de contabilidade está completo.
- Contadores por VLAN (alta confiança para o grupo): Convidados, colaboradores, caixas registadoras e IoT ficam cada um numa VLAN, pelo que a carga do grupo não depende da desencriptação de nada.
- Categorias de política DNS (média e identificada): Os totais por categoria fornecem uma visão semelhante à das aplicações. "O vídeo consumiu 5 GB" é uma inferência. Identifique-a como tal no relatório.
- Registos de fluxo agregados (baixa para o nome da aplicação): Os cabeçalhos continuam a mostrar quem comunicou com determinado endereço e quantos bytes foram transferidos. Um endereço de CDN partilhado não é uma aplicação.
Os endereços MAC aleatórios distorcem as contagens de dispositivos. Um telemóvel pode parecer dois dispositivos ao longo de vários dias, o que inflaciona o total de clientes e divide os seus bytes. Conte as sessões por pessoa ou por chave quando a política lhe fornecer essa identidade. Num espaço comercial, a mesma ideia aplica-se à forma como separa o tráfego dos clientes do tráfego do pessoal num rádio partilhado, o que faz parte de um bom design de WiFi para retalho.
A relação custo-benefício em termos simples está apresentada neste breve passo a passo.
Mantenha os registos associados a identidades apenas para resolução de problemas, planeamento de capacidade e conformidade. Elimine-os de acordo com um calendário. Uma etiqueta de confiança em cada valor não custa nada e evita que uma estimativa de categoria seja tratada como uma fatura.
Por Que Razão os Seus Números Não Coincidem e Como Reconciliá-los
A média mensal pode parecer saudável enquanto os utilizadores se queixam todas as noites. Ambas as afirmações são frequentemente verdadeiras. O tráfego fixo e móvel combinado é também um alvo em movimento. As estatísticas de tráfego de 2023 da ITU apontam o crescimento médio anual de 2019 a 2023 para cerca de 30%, com o aumento mais acentuado no início da pandemia em 2020. O crescimento por si só não explica uma noite má. O perfil do dia explica.
O relatório de banda larga do 1.º trimestre de 2025 da OpenVault mostra por que razão uma única média induz em erro o trabalho de capacidade. A utilização média dos subscritores nos EUA atingiu 663,2 GB por mês, um aumento de 9,5% em relação ao ano anterior, enquanto a utilização de downstream nas horas de ponta empresariais subiu 21,2% e a utilização de upstream subiu 23,6%. A procura de downstream empresarial atingiu o pico às 13:00. A procura residencial de upstream e downstream atingiu o pico por volta das 21:00. Um hotel ou uma propriedade residencial pode parecer modesto no gráfico mensal e, ainda assim, falhar numa hora previsível. Reduzir os gigabytes mensais não resolve essa reclamação. Mover a carga para fora do pico, ou corrigir o tempo de antena e a contenção, ajuda frequentemente mais os convidados do que um débito agregado maior.
Analise a divergência antes de comprar largura de banda
| Sintoma | Causa provável | Verificação |
|---|---|---|
| Os contadores mostram 30% da capacidade, mas os convidados continuam a queixar-se | As médias ocultam picos noturnos ou contenção de tempo de antena | Compare o percentil 95 nas horas de pico e a utilização do canal |
| Os totais de fluxo estão 15% abaixo dos contadores de interface | Erro de amostragem, encaminhamento assimétrico ou ausência de um exportador num dos caminhos | Compare numa ligação sem amostragem e confirme se todos os caminhos exportam fluxos |
| Os totais por SSID não correspondem ao total do AP | Tráfego de gestão excluído ou clientes a fazer roaming a meio da amostragem | Alinhe os carimbos de data/hora e confirme quais as tramas incluídas em cada contador |
| Os totais de RADIUS excedem a contagem de dispositivos | Sessões duplicadas após reconexão ou contadores reiniciados na reautenticação | Agrupe por ID de sessão e verifique o tratamento do reinício de contadores |
| Um local utiliza o dobro de um local idêntico | Mix de utilizadores diferente, atualizações em cache ou um erro de marcação de VLAN | Segmenta por VLAN e pelas principais categorias de destino |
| A utilização dispara no dia seguinte a uma implementação | Atualizações na nuvem ou uma nova classe de dispositivos juntou-se à rede | Verifique as categorias de DNS e a hora exata da implementação |
Corrija primeiro o alinhamento temporal, depois a amostragem e, em seguida, a atribuição. Os erros posteriores agravam os anteriores.
Uma diferença de duas vezes entre locais idênticos é frequentemente uma etiqueta VLAN ou uma mistura diferente de dispositivos, não uma aplicação misteriosa. Confirme o relógio, o exportador e a chave de sessão antes de reescrever o plano de capacidade. Uma média a nível de toda a organização não é um modelo de cada local.
Valide num Local Antes de Apresentar Relatórios para Toda a Empresa
Não implemente um novo design de medição em todas as propriedades no primeiro dia. Execute um piloto num local representativo durante duas a quatro semanas. A janela tem de incluir pelo menos uma noite movimentada e um dia útil calmo, caso contrário apenas provará a média em que já não confia.
Mantenha a nova recolha de dados ao lado da rede que gere atualmente. Não substitua os contadores existentes até que a nova série coincida com eles, com uma margem de cerca de 5% nos bytes totais. Uma execução em paralelo é a forma de detetar um contador reiniciado, um exportador em falta ou uma VLAN que nunca foi etiquetada.
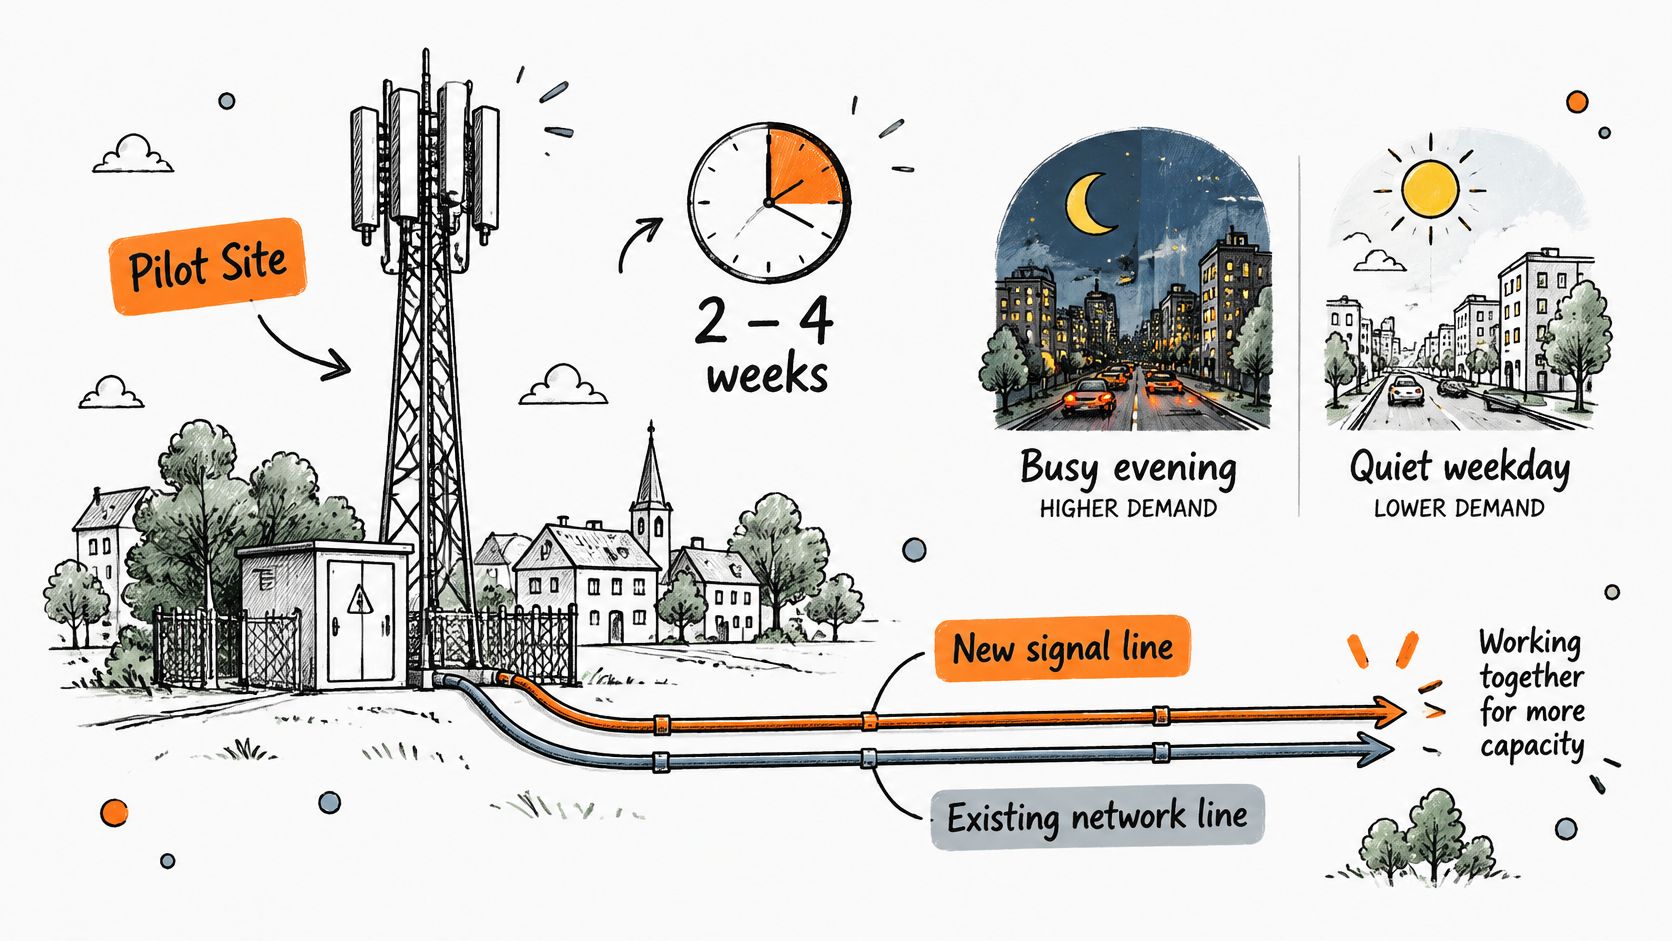
Avalie o piloto com base em dois testes, e não no aspeto completo do painel.
- Tickets: Os valores da hora de ponta alinham-se com as reclamações que já tem? Se o gráfico estiver calmo durante a pior noite, o intervalo de amostragem ou o ponto de medição está incorreto.
- Auditoria: Alguém consegue responder a uma pergunta real, como por exemplo qual a VLAN que um dispositivo utilizou num determinado dia? Se o registo não conseguir responder a isso, a atribuição não está concluída.
Validamos o design num primeiro local, nos pontos de acesso que esse local já possui, ao lado da rede em produção, e avaliamo-lo com base em pedidos de suporte e evidências de auditoria antes de uma implantação mais ampla. Uma sessão de design de 45 minutos é suficiente para um engenheiro mapear os SSIDs atuais em aberto, seguro e xPSK nesse hardware, e o plano fica do seu lado. O monitorização do estado da rede analisa depois desde a globalidade dos acessos até a um local e a um componente de hardware específico, com testes de velocidade, taxas de autenticação e dados de download e comportamentais para que o uso indevido seja visível em vez de presumido. O planeamento de rádio continua a ter de ser sólido. As medições não vão reparar um plano de canais que nunca foi desenhado, razão pela qual o design de rede WiFi permanece como um trabalho independente.
Defina as regras de relatórios antes do segundo local. Utilize o mesmo período e o mesmo intervalo de amostragem em todo o lado. Identifique o nível de confiança. Elabore relatórios por local, SSID e VLAN, e atribua a cada painel um responsável designado. Faça a implementação global apenas quando o projeto-piloto coincidir com os contadores e a equipa conseguir responder às três principais questões a partir dos dados. Se não conseguir, volte às verificações de discrepâncias. Alargar uma linha de base incorreta apenas acelera a publicação do erro.
O Purple Access disponibiliza acesso aberto, seguro e xPSK nos pontos de acesso que já utiliza, com contabilidade RADIUS na nuvem que pode associar a um utilizador, dispositivo ou chave, além de visualizações de estado que distinguem uma média mensal tranquila de uma hora de ponta problemática. Comprove o seu funcionamento num local com base nos seus pedidos de suporte e no seu registo de auditoria antes de alterar o resto do parque de dispositivos. Veja como se adapta aos seus locais em Purple Access.